단가표: 토큰당은 2.5배, 캐시 읽기는 Claude가 4배 쌉니다
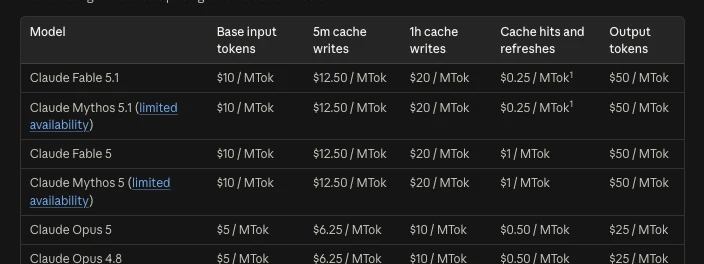
2026년 9월 7일 각 사 공식 가격 페이지에서 직접 확인한 값입니다. 미국 달러, 100만 토큰 기준이며 Astra와 Sol은 27만 2,000 입력 토큰 이하의 표준 구간입니다.
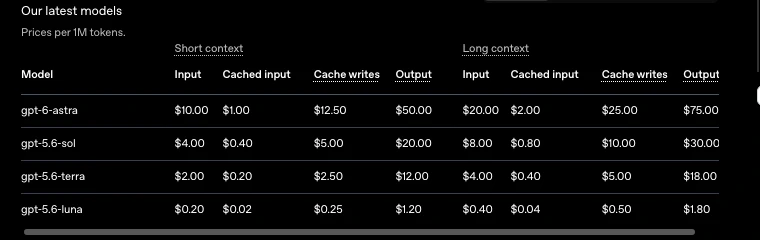
| 모델 | 입력 | 캐시 읽기 | 캐시 쓰기 | 출력 | 배치 |
|---|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | 50% |
| GPT-5.6 Sol | $4.00 | $0.40 | $5.00 | $20.00 | 50% |
| Claude Fable 5.1 | $10.00 | $0.25 | $12.50 (5분) / $20 (1시간) | $50.00 | $5 / $25 |
| Gemini 3.8 Flash | $0.75 | 미게재 | 미게재 | $3.75 | 50% (일반 안내) |
세 가지가 눈에 띕니다. 첫째, Astra와 Fable 5.1은 입력·출력·캐시 쓰기 단가가 완전히 같습니다. 다른 것은 캐시 읽기뿐인데, Anthropic이 Fable 5.1에서 캐시 히트를 기본 입력의 2.5%로 내려 0.25달러가 됐고 Astra는 10%인 1달러입니다. 캐시가 많이 걸리는 에이전트 루프에서는 이 4배 차이가 총액을 가릅니다. 둘째, Sol의 4·20달러는 공식 페이지에 “최소 2026년 11월 21일까지의 프로모션 가격”이라고 적혀 있습니다. Astra가 나왔다고 Sol이 싸진 게 아니라 원래 할인 중이었고, 11월 이후 어떻게 될지는 안내가 없습니다. 셋째, Gemini 3.8 Flash의 0.75·3.75달러는 구글 블로그의 “3.7 Flash와 같은 도입 가격”이며, 개발자 가격 문서에는 확인 시점에 3.8 항목이 아직 올라오지 않아 캐시·배치 단가는 표에 넣지 않았습니다.
“작업당 비용이 더 싸다”는 주장은 어디서 나오나
OpenAI 발표문의 벤치마크 캡션마다 “estimated API cost”가 붙어 있습니다. Terminal-Bench 4.0에서 Astra 57.9% 대 Sol 37.3%를 내면서 작업당 비용은 약 9% 낮았고, Claude Fable 5.1(55.8%)보다는 약 63% 낮았다는 식입니다. BenchCAD에서는 Sol 대비 43%, Fable 5.1 대비 86% 낮다고 적었습니다. 토큰 단가가 2.5배인데 작업당 비용이 낮으려면 토큰을 그만큼 덜 써야 합니다. 발표문이 그 근거로 든 것이 세 가지입니다.
| 근거 | 발표문의 표현 | 비용에 미치는 영향 |
|---|---|---|
| 반복 횟수 감소 | “produces code that requires less iteration to reach production quality” (Jane Street 인용) | 한 작업을 끝내기까지 왕복 호출이 줄면 입력 토큰 총량이 줄어듭니다 |
| 출력 토큰 감소 | Agents’ Last Exam에서 Opus 5보다 “약 65% 적은 출력 토큰” | 출력 단가가 입력의 5배라 출력 절감이 총액에 가장 크게 반영됩니다 |
| effort 단계 | low·medium·high·xhigh·max 다섯 단계, 캡션의 “lower-cost setting” | 같은 모델이라도 effort에 따라 토큰 소비가 몇 배 차이 납니다 |
이 주장을 독립적으로 재본 곳이 Artificial Analysis입니다. 9월 3일 분석의 결론은 둘로 갈립니다. 코딩 에이전트 지수에서는 Astra가 Codex 하네스에서 Sol(max)의 3분의 1 토큰을 쓰고, 그래서 max 설정의 작업당 비용이 Sol(max)과 비슷하면서 점수는 2점 높다고 했습니다. 반면 일반 지능 지수에서는 출력 토큰이 약 10%만 줄어 2.5배 단가를 상쇄하지 못했고, Sol과 같은 61점을 받으면서 작업당 비용은 75% 더 비싸다고 측정했습니다.
OpenAI의 비용 주장은 코딩·컴퓨터 사용처럼 여러 턴을 돌며 스스로 검증하는 작업에서 나온 숫자입니다. 그런 작업에서는 “몇 번 만에 끝내느냐”가 토큰 총량을 정하고, Astra는 그 횟수를 크게 줄였습니다. 한 번 묻고 한 번 답하는 단발 요청에서는 줄일 반복이 없으니 단가 차이가 그대로 청구서에 실립니다. 발표문 캡션의 “in the configurations shown”은 effort와 하네스가 특정 설정일 때의 비교라는 뜻이고, 그 설정을 벗어나면 숫자도 달라집니다.
월 시나리오 3개: 어디서 2.5배가 사라지고 어디서 그대로 남나
아래 세 시나리오는 모두 가정입니다. 토큰 수는 각 워크로드의 흔한 규모를 잡았고 단가는 위 표의 공식 값입니다. Gemini 3.8 Flash는 캐시 단가가 미게재라 캐시 없이 표준 단가로만 계산했습니다.
(신규 입력 토큰 ÷ 1,000,000 × 입력 단가) + (캐시 읽기 토큰 ÷ 1,000,000 × 캐시 단가) + (출력 토큰 ÷ 1,000,000 × 출력 단가). 배치는 해당 단가의 50%.
시나리오 1. 고객 문의 분류, 월 100만 건
건당 시스템 프롬프트 500토큰(캐시 가능) + 문의 본문 300토큰, 출력 50토큰. 월 합계 입력 8억 토큰(캐시 5억, 신규 3억), 출력 5,000만 토큰.
| 모델 | 캐시 없이 | 캐시 적용 | 캐시 + 배치 |
|---|---|---|---|
| GPT-6 Astra | $10,500 | $6,000 | $3,000 |
| GPT-5.6 Sol | $4,200 | $2,400 | $1,200 |
| Claude Fable 5.1 | $10,500 | $5,625 | 약 $2,813 |
| Gemini 3.8 Flash | $788 | (미계산) | $394 |
Astra 캐시 적용의 산식은 3억 × 10 + 5억 × 1 + 5,000만 × 50 = 3,000 + 500 + 2,500 = 6,000달러입니다. 반복이 없는 작업이라 토큰 효율 주장이 끼어들 틈이 없고, 2.5배가 그대로 남습니다. 이 워크로드에서 Astra를 고를 이유는 없습니다. Flash와의 차이는 캐시·배치를 다 써도 7배 이상입니다.
시나리오 2. 코딩 에이전트, 하루 50작업 × 22일
작업당 입력 20만 토큰(그중 15만은 반복 컨텍스트라 캐시 읽기), 출력 2만 토큰이라고 두었습니다. Artificial Analysis가 측정한 “Astra는 Sol(max)의 3분의 1 토큰”을 반영해 Sol에는 3배 토큰(입력 60만, 출력 6만)을 적용한 행과, 그 효율이 내 코드베이스에서 안 나온다고 가정해 같은 토큰을 적용한 행을 둘 다 넣었습니다.
| 모델 · 가정 | 작업당 | 월 1,100작업 |
|---|---|---|
| GPT-6 Astra (20만 입력, 2만 출력) | $1.65 | $1,815 |
| GPT-5.6 Sol, 토큰 3배 (AA 측정 반영) | $1.98 | $2,178 |
| GPT-5.6 Sol, 토큰 동일 (효율 미발생) | $0.66 | $726 |
| Claude Fable 5.1, 토큰 동일 | $1.54 | $1,691 |
| Gemini 3.8 Flash, 토큰 동일, 캐시 없음 | $0.23 | $248 |
Astra 작업당 산식은 5만 × 10 + 15만 × 1 + 2만 × 50 = 0.5 + 0.15 + 1.0 = 1.65달러입니다. Sol이 정말 3배 토큰을 쓴다면 15만 × 4 + 45만 × 0.4 + 6만 × 20 = 0.6 + 0.18 + 1.2 = 1.98달러로 Astra가 17% 쌉니다. OpenAI와 AA가 말한 “작업당 비용 비슷하거나 낮다”가 이 행입니다. 하지만 효율이 안 나오면 Sol이 2.5배 쌉니다. 이 시나리오의 답은 단가표가 아니라 내 저장소에서 두 모델을 같은 작업에 돌려 usage를 비교한 로그에 있습니다. 같은 토큰이면 Fable 5.1이 캐시 읽기 덕에 Astra보다 7% 쌉니다.
시나리오 3. 문서 요약 파이프라인, 월 5,000건
건당 입력 3만 토큰, 출력 2,000토큰. 실시간이 필요 없어 배치 사용 가능.
| 모델 | 표준 | 배치 |
|---|---|---|
| GPT-6 Astra | $2,000 | $1,000 |
| GPT-5.6 Sol | $800 | $400 |
| Claude Fable 5.1 | $2,000 | $1,000 |
| Gemini 3.8 Flash | $150 | $75 |
건당 Astra 표준은 3만 × 10 + 2,000 × 50 = 0.3 + 0.1 = 0.4달러입니다. 요약은 한 번에 끝나는 작업이라 시나리오 1과 같은 결론입니다. 세 시나리오를 합치면 Astra가 비용으로 이기는 곳은 하나, 여러 턴을 도는 에이전트 작업에서 실제로 토큰이 줄어들 때뿐입니다.
27만 2,000 토큰을 넘는 순간 요청 전체가 두 배가 됩니다
모델 페이지에 한 줄로 적힌 규칙이 있습니다. 입력이 27만 2,000토큰을 넘는 요청은 요청 전체가 입력·캐시 2배, 출력 1.5배 단가로 청구됩니다. 초과분만이 아닙니다. 105만 토큰 컨텍스트를 광고하면서 그 창을 실제로 쓰면 다른 가격이 적용되는 구조입니다.
27만 입력 + 5,000 출력 = 2.70 + 0.25 = 2.95달러. 28만 입력 + 5,000 출력 = 28만 × 20 + 5,000 × 75 = 5.60 + 0.375 = 5.975달러. 입력이 3.7% 늘었는데 청구는 2배가 됩니다. 컨텍스트가 커지는 에이전트라면 27만을 하드 가드레일로 두고, 넘기 전에 요약하거나 노트 기능으로 나누는 편이 낫습니다.
참고로 Anthropic은 Fable 5.1의 100만 컨텍스트에 표준 단가를 그대로 적용한다고 가격 페이지에 적었습니다. 긴 컨텍스트가 필수인 워크로드에서는 이 차이가 단가표의 어떤 숫자보다 큽니다.
신모델이 나오면 반복되는 말 네 가지
| 흔히 듣는 말 | 판정 | 확인한 것 |
|---|---|---|
| “신모델이 나오면 구모델 가격이 내려간다” | 이번엔 반대 | Sol의 4·20달러는 11월 21일까지의 프로모션이라고 명시돼 있습니다. 내려간 게 아니라 원래 할인 중이고, 이후 인상 가능성이 열려 있습니다. |
| “캐시를 걸면 다 싸진다” | 조건부 | 캐시 쓰기는 입력의 1.25배라 한 번만 읽고 버리면 손해입니다. Astra는 읽기가 입력의 10%, Fable 5.1은 2.5%라 같은 캐시 전략도 모델에 따라 효과가 4배 다릅니다. |
| “출력이 12만 8,000까지 되니 긴 문서를 한 번에 쓰면 이득” | 틀림 | 출력 단가 50달러는 입력의 5배입니다. 12만 8,000토큰 출력 한 번이 6.4달러이고, 입력이 27만 2,000을 넘으면 75달러로 뜁니다. 긴 출력은 나누는 쪽이 쌉니다. |
| “작업당 비용이 낮다니 무조건 갈아타자” | 틀림 | AA 측정에서 일반 지능 지수는 Sol과 같은 61점에 작업당 75% 비쌌습니다. 코딩 에이전트에서만 비슷하거나 낮았습니다. 워크로드별로 usage를 재보기 전에는 판단할 수 없습니다. |
개발자들이 실제로 걸린 세 지점
출시 후 나흘간 Hacker News, 모델 카탈로그 사이트, 분석 글에서 반복된 질문입니다. 커뮤니티 스레드의 개별 댓글은 인용하지 않고, 공식 문서로 답이 확인되는 것만 정리했습니다.
| 질문 | 확인된 답 | 근거 |
|---|---|---|
| API 기본 effort가 뭔가, 벤치마크 점수는 어떤 설정인가 | 기본은 low이고, 발표문 점수는 “어떤 effort에서든 최대값”입니다. 벤치마크 재현에는 max가 필요하고 비용도 그 설정 기준이 아닙니다. | 모델 페이지의 effort 5단계, 발표문 표 하단 주석, LLM Stats·Ofox 정리 |
| 27만 2,000 규칙이 초과분에만 적용되나 | 아니요. 요청 전체입니다. | 모델 페이지 “for the full request” |
| Zero Data Retention이 되나 | 대상 API 고객에게 지원되고, Private Safety Processing은 테스트 중입니다. 지역 처리(데이터 레지던시) 엔드포인트는 10% 할증입니다. | 발표문 Availability 절, 가격 페이지 상단 안내 |
Hacker News의 OpenRouter 등재 스레드(98개 댓글)와 출시 스레드는 아래 출처에 링크만 두었습니다. 댓글의 개별 주장은 검증하지 않았습니다.
결정: 무엇을 옮기고 무엇을 남길지
| 워크로드 | 지금 판단 | 이유 |
|---|---|---|
| 여러 턴을 도는 코딩·컴퓨터 사용 에이전트 | Astra를 시험, 로그로 판정 | 토큰 효율이 실제로 3배 가까이 나오면 Sol과 비용이 같고 품질이 오릅니다. 안 나오면 2.5배입니다. usage 로그 2주가 답을 줍니다. |
| 분류·추출·짧은 생성 | Sol 또는 Flash 유지 | 줄일 반복이 없어 단가 차이가 그대로 남습니다. 시나리오 1에서 Astra는 최선의 경우에도 Sol의 2.5배입니다. |
| 배치 요약·오프라인 처리 | Flash 또는 Sol 배치 | 시나리오 3. 품질 차이가 청구서 차이를 정당화하는지 샘플로 먼저 확인하세요. |
| 캐시 히트가 큰 장기 에이전트 | Fable 5.1도 후보 | 같은 10·50달러에 캐시 읽기가 4분의 1이고 100만 컨텍스트에 할증이 없습니다. |
| 컨텍스트 27만 근처를 오가는 작업 | 가드레일 먼저 | 넘는 순간 요청 전체가 2배입니다. 넘지 않게 설계하거나 Fable 5.1로 갑니다. |
한 줄로 줄이면 이렇습니다. Astra는 토큰당 비싼 모델이 아니라 턴을 줄여서 값을 하는 모델이고, 턴이 없는 작업에 쓰면 그냥 2.5배 비싼 Sol입니다. 이 글의 시나리오는 가정이므로 본인 워크로드의 usage 응답에서 input, cached, output 토큰을 뽑아 위 계산식에 넣어 보세요. 기존 비용 절감 순서는 AI API 토큰 비용, 구조부터 줄이는 순서에 있습니다.
직접 확인: OpenAI 가격 페이지와 gpt-6-astra 모델 페이지(단가, 27만 2,000 규칙, 배치·Flex 50%, Fast 2배, effort 5단계, Sol 프로모션 기한), Anthropic 가격 페이지(Fable 5.1 단가와 캐시 각주, 배치, 100만 컨텍스트 표준 단가), Google 블로그(3.8 Flash 도입 가격), OpenAI 발표문의 비용 주장 캡션. 인용: Artificial Analysis 9월 3일 분석의 토큰 효율·작업당 비용 측정치. 시나리오 계산은 모두 가정이며 실제 청구액을 보장하지 않습니다. 운영자가 Astra API를 직접 호출한 실측은 아직 없습니다.
OpenAI API 가격 페이지, gpt-6-astra 모델 페이지, GPT-6 Astra 발표문, Anthropic 가격 문서, Google 블로그(Gemini 3.8 Flash), Artificial Analysis 분석을 2026년 9월 7일 확인했습니다.
OpenAI API 가격 ↗ · gpt-6-astra 모델 페이지 ↗ · GPT-6 Astra 발표문 ↗ · OpenAI Batch API 안내 ↗ · Anthropic 가격 문서 ↗ · Google Gemini 3.8 Flash 발표 ↗ · Artificial Analysis: Benchmarking GPT-6 Astra ↗ · Hacker News: Astra on OpenRouter ↗ · LLM Stats: Astra 스펙 정리 (비공식) ↗