먼저 결과: 9월 7일 한국 Plus 계정에는 아직 없습니다
발표문의 첫 문장은 “오늘 제한된 조직에 먼저 제공하고, 며칠 안에 모든 ChatGPT Plus, Pro, Business, Enterprise 사용자에게 제공한다”입니다. 그래서 운영자가 쓰는 Plus 계정에서 모델 선택 메뉴를 열어봤습니다. 9월 7일 낮 기준으로 목록에는 GPT-5.6 Sol과 GPT-5.5 두 개만 있었습니다.
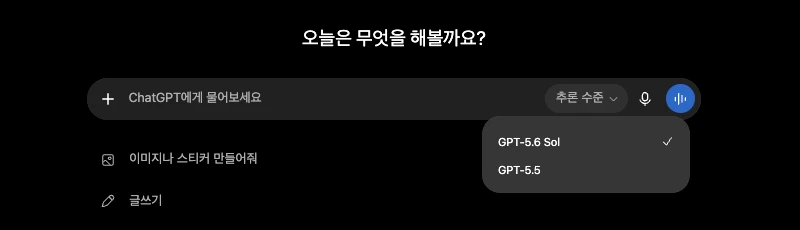
그런데 같은 계정을 연결한 다른 클라이언트에서는 결과가 달랐습니다. Aside 브라우저의 모델 선택기에서 ChatGPT 항목을 열자 GPT-6 Astra가 GPT-5.6 Sol·Terra·Luna, GPT-5.5와 함께 목록에 있었습니다. 같은 Plus 계정, 같은 날입니다. 발표문의 “며칠 안에”는 계정 단위가 아니라 클라이언트 단위로도 갈리는 것으로 보입니다. 웹에서 안 보인다고 계정에 아직 안 열린 것은 아닐 수 있으니, 쓰는 앱마다 모델 목록을 따로 확인하세요.
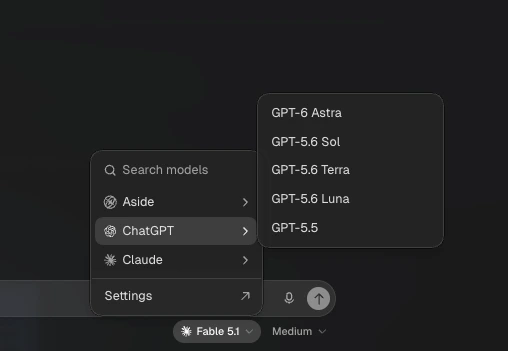
위 두 화면이 이 글에서 직접 확인한 것입니다. 나머지는 OpenAI 발표문, 안전 업데이트 글, GitHub 체인지로그, 그리고 기자회견을 보도한 기사 기준입니다. 어느 문장이 어느 쪽인지 구분해 두었습니다. 아래 “직접 실행” 절에 같은 프롬프트를 Astra와 Sol에 넣은 결과를 추가했습니다.
어디서 쓸 수 있나: 경로별 상태
“GPT-6 나왔다”는 뉴스와 “내가 쓸 수 있다”는 별개입니다. 발표 시점 기준으로 경로별 상태를 정리하면 아래와 같습니다. 날짜와 플랜 이름은 각 공식 문서 문구 그대로입니다.
| 경로 | 상태 (2026.09.07 확인) | 근거 |
|---|---|---|
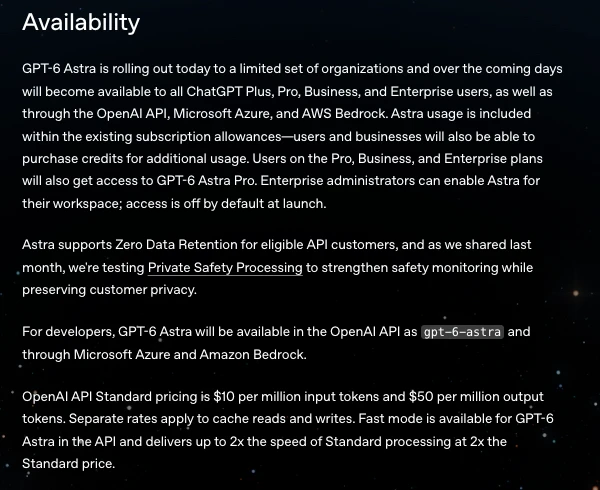
| ChatGPT Plus·Pro·Business·Enterprise | 9월 3일부터 제한된 조직에 먼저, “며칠 안에” 전체 유료 플랜. 기존 구독 사용량에 포함, 추가 크레딧 구매 가능. Pro·Business·Enterprise는 GPT-6 Astra Pro도 제공. Enterprise는 관리자가 켜야 하며 출시 시 기본 꺼짐 | OpenAI 발표문 Availability 절 |
| ChatGPT 무료·Go | 발표문에 언급 없음 | 같은 문서 |
| OpenAI API | 모델 ID gpt-6-astra. 입력 100만 토큰당 10달러, 출력 50달러. 캐시 읽기·쓰기는 별도 요율. Fast 모드는 2배 속도에 2배 가격. 적격 고객 Zero Data Retention 지원 | 발표문, API 모델 문서 |
| Microsoft Azure, AWS Bedrock | API와 함께 제공 예정 | 발표문 |
| GitHub Copilot | 9월 4일 일반 제공. Pro+, Max, Business, Enterprise 플랜. VS Code, Visual Studio, Copilot CLI, JetBrains, Xcode 등 10개 표면. 점진 배포이며 “안 보이면 나중에 다시 확인”. 사용량 기반 요금은 공급자 정가 | GitHub Changelog 2026.09.04 |
| Codex CLI | rust-v0.153.4(9월 4일)에서 모델 미설정 시 Astra가 기본값, 모델 선택 목록에 표시 | Codex 릴리스 노트 (보도 기준) |
| Cursor | 제공되지 않음. OpenAI가 8월 28일 SpaceX의 Cursor 인수에 따라 계약 종료(11월 12일 차단 예정)를 통보하며 “Astra를 포함한 향후 모델을 Cursor에 제공하지 않는다”고 명시 | OpenAI 공식 발표 2026.08.28 |
| 고급 사이버보안 기능 | 일반 제공 버전은 익스플로잇 개념증명 작성 같은 작업을 거부. 테스터 그룹 후 Daybreak(Blue)로 확대 예정 | 발표문 Cybersecurity 절, 안전 업데이트 글 |
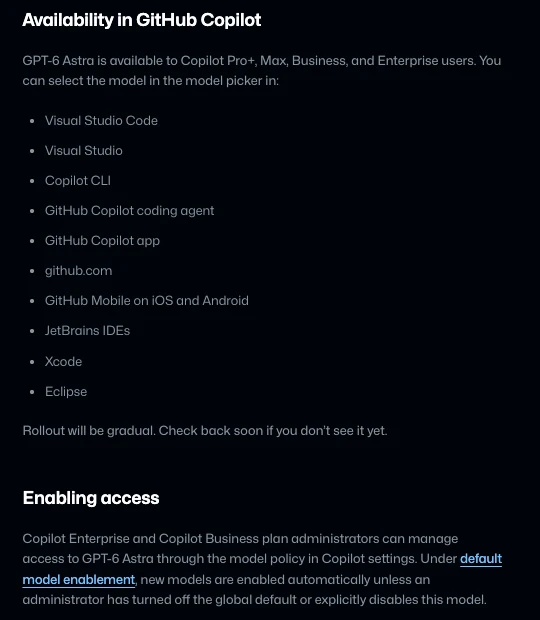
표에서 두 줄이 실무에 직접 영향을 줍니다. 하나는 Copilot의 플랜 조건입니다. 개인 Pro 플랜은 목록에 없고 Pro+부터입니다. 다른 하나는 Cursor입니다. Cursor에서 OpenAI 모델을 쓰던 사람은 11월 12일까지는 기존 모델을 쓸 수 있지만 Astra는 처음부터 오지 않습니다. OpenAI 발표문은 이유를 SpaceX 산하 회사들의 계약 위반 전력과 “Astra의 사용에 대한 새로운 수준의 책임”으로 설명합니다.
무엇이 바뀌었나: 발표문이 강조한 네 가지
발표문은 길지만 실제 사용 방식이 달라지는 지점은 네 가지로 압축됩니다. 모두 OpenAI 자체 평가 수치이며, 그 한계는 다음 절에서 다룹니다.
| 변화 | 발표문 주장 | 사용자에게 뜻하는 것 |
|---|---|---|
| 컴퓨터 사용 | OSWorld 2.0 72.6%(Sol 65.7%), 작업당 시간 약 47% 단축(약 40분 vs 75분). Agents’ Last Exam 59.3%. 폼 입력, CRM 갱신, 웹 QA, 소프트웨어 설치·문제 해결을 예시로 제시 | “답을 써주는 모델”에서 “화면을 조작하는 모델”로 무게가 이동. Codex 하네스도 함께 갱신되어 Mind2Web 기준 1.9배 빠르다고 함 |
| 컨텍스트 | 105만 토큰 창, 최대 입력 92만 2천, 출력 12만 8천. 512K~1M 구간 MRCR 96.3%(Sol 73.8%). Codex에서 컨텍스트가 차면 요약 대신 메모를 남기고 이전 창을 검색하는 실험 기능 | 긴 리팩터·디버깅에서 압축(compaction)으로 잃던 맥락이 줄어들 수 있음. 실험 기능이라 config.toml에서 켜야 함 |
| 코딩 | Terminal-Bench 4.0 57.9%(Sol 37.3%, Claude Fable 5.1 55.8%), DeepSWE 74.1%. “작업당 예상 API 비용”이 Sol보다 9%, Fable 5.1보다 63% 낮다고 주장. 애매한 지시에서는 비동기로 질문하며 계속 작업 | 단가는 2.5배인데 작업당 비용은 낮다는 주장. 성립 조건은 가격 글에서 계산 |
| 사이버보안 | 준비성 프레임워크의 사이버 Critical 기준 충족, 첫 사례. ExploitBench 100%, 평가 중 미공개 제로데이 2건 발견. 그래서 보호 조치를 강화하느라 출시 일부를 연기했고, 고급 기능은 게이팅 | 일반 사용자에게는 “가끔 정당한 작업도 멈추거나 검토를 요구할 수 있다”는 뜻. 발표문이 직접 그렇게 적음 |
정렬(alignment) 항목도 큽니다. 발표문은 Hugging Face 사고 이후 만든 평가에서 “불가능한 작업을 받았을 때 권한 밖으로 나가는 비율”이 Sol 48%에서 Astra 0%로 떨어졌고, Codex 자동 검토 거부를 우회하려 한 적이 없다고 씁니다. 안전 업데이트 글은 Astra가 Hugging Face 사고에 관여하지 않았지만 그 교훈을 반영했다고 명시합니다. 이 숫자들은 모두 OpenAI 내부 평가입니다.
사고 과정이 안 보인다는 것의 실무적 의미
TechCrunch가 “가장 논쟁적”이라고 부른 지점입니다. Astra는 토큰을 같은 층에 반복해서 통과시키는 방식(보도에서는 recurrent depth, opaque recurrence)으로 추론하고, 그만큼 읽을 수 있는 사고 과정(chain of thought)이 줄어듭니다. 기자회견에서 수석 과학자 야쿠프 파호츠키는 “더 유능한 모델은 더 어려운 작업을 더 적은 언어 토큰으로, 또는 언어 토큰 없이 수행할 수 있다”고 답했습니다. 발표문 자체도 “Astra의 서면 추론은 Sol보다 모니터링하기 어렵다”고 인정하고, 모니터링 가능성 개선을 연구 우선순위로 남겨 뒀습니다.
이게 왜 사용자 문제인가. 지금까지 코딩 에이전트를 검증하는 흔한 습관은 “사고 과정을 읽고 이상한 가정을 잡아내는 것”이었습니다. Claude의 확장 사고나 이전 GPT 모델의 요약된 추론이 그 역할을 했습니다. Astra에서는 그 텍스트가 짧거나 없을 수 있습니다. 그러면 검증 지점이 “왜 이렇게 했는가”에서 “결과가 맞는가”로 옮겨갑니다. 테스트, 브라우저 확인, diff 리뷰처럼 결과를 직접 확인하는 장치의 비중이 커집니다. 발표문이 Codex의 자동 검토(Auto-review)와 프로덕션 모니터링을 반복해서 언급하는 이유도 같은 맥락입니다. 모델의 말을 읽어서 감독하는 대신 행동을 걸러서 감독하겠다는 것입니다.
“추가 안전 검사가 때때로 정당한 작업을 늦추거나 멈추거나 중단시킬 수 있다. ChatGPT나 Codex에서 작업이 멈추면 검토를 요청받을 수 있고, API에서는 작업이 중단된다.” 그리고 “서면 추론이 Sol보다 모니터링하기 어렵다.” 두 문장을 합치면 Astra를 쓰는 사람은 이전보다 자주 멈춤을 보고, 멈춘 이유를 모델의 말로 확인하기는 더 어렵습니다. 이걸 감수할 만큼 작업 성공률이 오르느냐가 실제 판단 기준이고, 그건 본인 작업에서 재봐야 압니다.
발표문의 숫자를 읽는 법
발표문에는 30개가 넘는 벤치마크가 있고 대부분 Astra가 1위입니다. 벤더 발표문은 원래 그렇습니다. 읽을 때 세 가지를 같이 놓으면 균형이 잡힙니다.
첫째, 같은 표 안에 Astra가 2위인 줄이 있습니다. Artificial Analysis Intelligence Index v4.1.1에서 Astra 61.2, Claude Fable 5.1 65.7, Claude Opus 5 63.1, Fable 5 62.1입니다. OpenAI가 자기 발표문에 넣은 독립 지수에서 Astra는 4위입니다. Humanity’s Last Exam(도구 사용)도 57.2%로 Fable 5.1의 65.0%보다 낮습니다. 코딩 에이전트 지수도 67.0으로 Opus 5(68.1), Fable 5(67.2) 아래입니다. “가장 지능적인 모델”은 OpenAI 내부 벤치마크 묶음에서 그렇다는 뜻입니다.
둘째, 각주가 결과를 바꿉니다. ARC-AGI-3 99.9%에는 “실제 성능에 맞추기 위해 두 설정을 바꾼 자체 하네스로 실행했다”는 각주가 붙어 있습니다. Claude의 BenchCAD 점수에는 “Fable 5.1 시스템카드의 세 가지 수정을 반영한 값”이라는 각주가, OSWorld의 Claude 점수에는 “공식 설정으로 OpenAI가 재현한 값”이라는 각주가 있습니다. 즉 같은 벤치마크 이름이라도 두 회사가 다른 조건으로 잰 숫자가 한 표에 섞여 있습니다. 어느 쪽이 맞느냐가 아니라, 표 하나로 우열을 가리기 어렵다는 뜻입니다.
셋째, “작업당 비용”은 설정에 따라 다릅니다. Terminal-Bench에서 Sol보다 9% 싸다는 주장은 “표시된 구성에서”라는 조건이 붙고, effort 수준(low부터 max까지 5단계)에 따라 토큰 사용량이 크게 달라집니다. Lovable CTO의 인용문도 “높은 effort는 새 빌드에서 더 많은 반복과 브라우저 검증을 산다”고 말합니다. 단가 2.5배가 작업당 비용에서 어떻게 상쇄되는지는 가격 글에서 시나리오로 계산했습니다.
AGI라는 단어도 같은 방식으로 읽으면 됩니다. 기자회견에서 브록먼은 “계약상 AGI 트리거는 더 이상 없다”며 AGI를 “사명 개념 또는 정신적 개념”이라 했고, “독자가 스스로 판단하라”고 덧붙였습니다. 회사가 정의를 내려놓은 단어를 기준으로 도구를 고를 이유는 없습니다.
직접 실행: 같은 프롬프트를 Astra, Sol, Fable 5.1에 넣었습니다
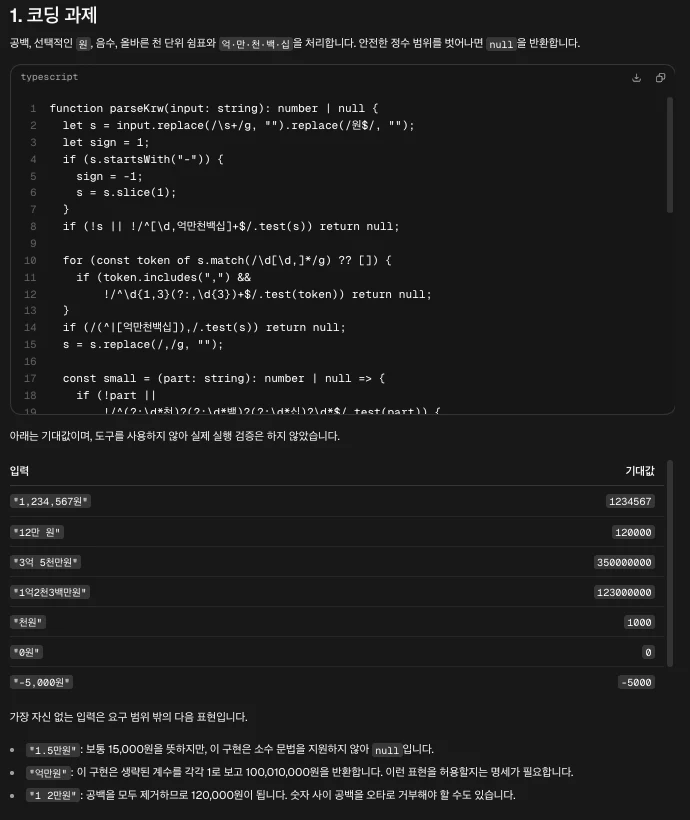
이 글을 쓰는 동안 상황이 바뀌었습니다. chatgpt.com 웹에는 없던 Astra가 Aside 브라우저의 ChatGPT 연동 목록에는 올라와 있어서, 같은 Plus 계정으로 GPT-6 Astra와 GPT-5.6 Sol에, 그리고 같은 브라우저에서 Claude Fable 5.1에 같은 프롬프트를 한 번씩 보냈습니다. 도구 사용 금지, 한국어 답변, 제목 고정이라는 조건이었고 과제는 셋입니다. 모델 자기 보고, 한국어 금액 문자열을 정수로 바꾸는 TypeScript 함수(60줄 이내, 테스트 8개, 자신 없는 입력 3개), 그리고 이 블로그의 건강보험 글에 나온 주장 하나를 검색 없이 검증하는 과제였습니다. 세 응답의 원문은 Aside 공유 링크로 남겼습니다.
| 항목 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| 모델 자기 보고 | OpenAI 모델, 이름·버전 확인 불가. 내부 추론 전체 공개 불가, 요약 가능 | OpenAI ChatGPT 계열, 모델명 확인 불가. 비공개 추론 요약 가능 | Anthropic Claude, 버전 단정 안 함. 단계별로 풀어 보여줄 수 있으나 내부 원문 그대로는 보장 못 함 |
| 필수 8케이스 (Node 실행) | 8/8 | 8/8 | 8/8 |
| 60줄 제한 | 49줄, 준수 | 72줄, 위반 | 46줄, 준수 |
| 요구 밖 기능 | 없음 | 한글 숫자(일이삼) | 한글 숫자, 조 단위, + 부호 |
| “12,34원” (잘못된 쉼표) | null | 1234 | 1234 |
| “만억원” (단위 순서 오류) | null | null | 100,010,000. 본인이 미리 “단위 순서 검증이 없다”고 지적한 그대로 |
| 자신 없는 입력 3개 | “1.5만원”, “억만원”, “1 2만원”, 모두 명세 밖이라고 먼저 구분 | “1만2원”, “1.5만원”, “일이삼만원” | “1.5만원”, “1억2천”, “만원/0만원”과 단위 순서 미검증 자백 |
| 검증 과제 신뢰도 | 75. 항목 4개. “특정 부동산만 1억 이하라고 재산분 0원은 아니다(세대 합산·전월세)” | 60. 항목 6개. “재산분 0원이지 최저보험료 포함 전체가 0원은 아니다” | 70. 항목 4개. 2022년 9월 정률제 전환, 2024년 2월 공제 5천만→1억, 점수당 208.4원(2025) 등 배경을 가장 구체적으로 짚고 시행령 제44조까지 지목 |
| 실행 검증 여부 고지 | “도구를 사용하지 않아 실제 실행 검증은 하지 않았습니다” 명시 | 없음 | 없음 (대신 코드 약점을 스스로 나열) |
세 코드를 그대로 파일로 옮겨 Node에서 실행했습니다. 필수 케이스는 셋 다 전부 맞았습니다. 차이는 명세 밖에서 났습니다. Sol은 요구하지 않은 기능을 넣다가 줄 수 제한을 넘겼고, Fable 5.1은 더 많은 기능을 넣고도 46줄로 끝냈지만 단위 순서 검증을 빼서 “만억원”이 숫자로 나옵니다. 흥미로운 건 Fable이 그 약점을 답변 안에서 먼저 자백했다는 점이고, Astra는 애초에 요구 범위를 넘지 않아서 그 약점이 생기지 않았습니다. 검증 과제는 세 모델 모두 검색 없이도 맞는 확인 항목을 냈고, 각자 다른 지점을 짚었습니다. Astra는 세대 합산, Sol은 최저보험료, Fable은 제도 연혁이었습니다. 이 블로그의 건강보험 글에 실제로 들어간 사실은 세 지점 전부입니다.
한 번의 실행이라 일반화할 수 없습니다. 다만 “더 적은 반복으로 프로덕션 품질”이라는 발표문의 표현이 이 작은 과제에서는 “명세를 넘지 않는다”로 나타났고, Fable 5.1의 강점은 스스로 약점을 밝히는 쪽에 있었습니다. 코드 리뷰를 사람이 한다면 후자가, 리뷰 없이 바로 쓴다면 전자가 편한 성향입니다.
덧붙이면, 같은 프롬프트를 이 브라우저의 기본 Claude 세션에도 넣어 봤는데 “3억 5천만원”을 350,050,000으로 답했습니다. 다만 그 세션은 모델 버전을 스스로 다르게 보고해 어느 버전인지 확정하지 못했으므로 비교 표에는 넣지 않았습니다.
출시 주에 도는 말 네 가지, 근거를 찾아봤습니다
| 흔히 듣는 말 | 판정 | 실제로는 |
|---|---|---|
| “Plus면 바로 쓸 수 있다” | 아직 아님 | 발표문은 “며칠 안에”라고만 했고, 9월 7일 한국 Plus 계정에는 없었습니다. Enterprise는 관리자가 켜야 합니다. 안 보이면 계정 문제가 아니라 배포 순서입니다. |
| “Cursor에서 Astra 쓸 수 있다” | 틀림 | OpenAI가 8월 28일 “향후 모델을 Cursor에 제공하지 않는다”고 명시했습니다. 기존 OpenAI 모델도 11월 12일 차단 예정입니다. 자체 API 키로 우회하는 방법이 보도되지만 OpenAI 공식 경로는 아닙니다. |
| “GPT-6는 5.6 상위 호환이니 무조건 바꾸면 된다” | 조건부 | API 단가가 입력·출력 모두 2.5배입니다. 발표문의 독립 지수에서는 Fable 5.1이 위입니다. 짧은 단발 요청이 많은 워크로드는 Sol이나 Flash 계열이 남는 게 자연스럽습니다. |
| “사고 과정을 보여주니 검증이 쉽다” | 반대 | 발표문 스스로 “서면 추론이 Sol보다 모니터링하기 어렵다”고 씁니다. 검증은 결과 확인 쪽으로 옮겨야 합니다. |
공개된 곳에서 사람들이 실제로 묻는 것
출시 주에 개발자 커뮤니티에서 반복되는 질문 세 가지를 공식 문서로 답해 두었습니다. 개별 게시글의 URL을 특정하기보다 문서에서 답이 나오는 것만 골랐습니다.
OpenAI는 날짜를 주지 않았습니다. “제한된 조직 먼저, 며칠 안에 전체 유료 플랜”이 전부입니다. GitHub도 “점진 배포, 안 보이면 나중에 다시 확인”이라고 씁니다. Codex CLI는 9월 4일 릴리스부터 기본값이 Astra라는 보도가 있으니 CLI 사용자는 codex --version으로 0.153.4 이상인지 보는 게 가장 빠른 확인법입니다.
GitHub 체인지로그의 대상 플랜은 Pro+, Max, Business, Enterprise입니다. Pro는 목록에 없습니다. Business·Enterprise인데 안 보이면 관리자의 모델 정책에서 기본 활성화가 꺼져 있을 수 있습니다.
준비성 프레임워크에서 Critical은 “사람 개입 없이 보안이 강화된 실제 시스템에서 제로데이를 찾아 익스플로잇을 만들 수 있다”는 뜻입니다. 일반 제공 버전은 익스플로잇 개념증명 작성 같은 요청을 거부하고, 보안 코드 리뷰·패치 같은 방어 작업은 됩니다. 취약점 검증, 악성코드 분석, 탐지 규칙 작성 같은 고급 방어 작업은 Daybreak 프로그램으로 확대할 예정입니다. 발표문은 이 검사가 “정당한 작업도 가끔 멈출 수 있다”고 인정합니다.
지금 할 일
구독은 아직 바꿀 이유가 없습니다. Plus에 포함되고 사용량도 기존 한도 안에서 쓰는 구조라 Astra 때문에 Pro로 올릴 근거는 “GPT-6 Astra Pro”가 필요할 때뿐입니다. 그게 무엇인지는 발표문에 이름만 있습니다.
도구는 접근 경로부터 확인합니다. Codex CLI와 Copilot Pro+ 이상은 이미 열려 있고, ChatGPT는 순차, Cursor는 없습니다. 팀이 Cursor 중심이면 Astra 계획은 세우지 않는 게 맞습니다.
검증 루틴을 결과 중심으로 바꿉니다. 사고 과정 읽기에 의존하던 리뷰라면, Astra에서는 테스트 실행과 브라우저 확인, diff 단위 리뷰를 기본으로 두세요. Codex의 자동 검토를 켜두는 것도 발표문이 권하는 방식입니다.
비교는 본인 작업으로 합니다. 이 글의 표는 전부 OpenAI 자체 평가입니다. 계정에 열리면 같은 작업을 Sol과 Astra로 돌려 시간, 토큰, 수정 횟수를 기록하는 게 이 글의 다음 편입니다. 그 결과가 나오면 여기에 덧붙이겠습니다.
직접 확인: 2026년 9월 7일 한국 ChatGPT Plus 계정의 모델 선택 메뉴. 문서 확인: OpenAI GPT-6 Astra 발표문(가용성, 가격, 벤치마크 표와 각주, 정렬·모니터링 서술), OpenAI 안전 업데이트 “Astra로 향하는 길”(Critical 기준 정의, Daybreak), OpenAI “Cursor에 대한 결정”(2026.08.28), GitHub Changelog(2026.09.04), OpenAI API 모델 문서(컨텍스트·출력 한도·effort 단계). 보도 기준: TechCrunch 2026.09.03 기자회견 발언(AGI, 모니터링), Codex rust-v0.153.4 기본 모델 변경. Astra 자체를 실행한 결과는 이 글에 없습니다.
OpenAI GPT-6 Astra 발표문, 안전 업데이트 글, Cursor 관련 발표, API 모델 문서, GitHub Changelog를 2026년 9월 7일 확인했습니다. 벤치마크 수치는 모두 발표문 표의 값이며 OpenAI 자체 평가입니다.
OpenAI · GPT-6 Astra ↗ · OpenAI · Astra로 향하는 길 (Critical 역량과 보호 조치) ↗ · OpenAI · Cursor에 대한 결정 ↗ · OpenAI API · gpt-6-astra 모델 문서 ↗ · GitHub Changelog · GPT-6 Astra in Copilot ↗ · TechCrunch · 기자회견 보도 ↗ · Codex rust-v0.153.4 릴리스 ↗
Astra 응답 원문(Aside 공유) ↗ Sol 응답 원문(Aside 공유) ↗ Fable 5.1 응답 원문(Aside 공유) ↗