먼저 결과: 한 표로 보는 두 모델
두 회사가 각자 발표한 수치와, 제가 9월 7일에 직접 연 문서 페이지의 내용을 한 표에 모았습니다. 출처가 발표문인지 직접 확인인지 열에 적었습니다.
| 항목 | Claude Fable 5.1 | GPT-6 Astra | 확인 방법 |
|---|---|---|---|
| 출시 | 2026년 9월 1일 | 2026년 9월 3일 | 양사 발표문 |
| API 모델 ID | claude-fable-5-1 | gpt-6-astra | 양사 문서 |
| 컨텍스트 / 최대 출력 | 100만 / 12만 8천 토큰 | 105만 / 12만 8천 토큰 | 양사 문서 |
| 입력 / 출력 (1M 토큰) | $10 / $50 | $10 / $50 (27만 2천 토큰 초과 요청은 $20 / $75) | 양사 가격표 직접 확인 |
| 캐시 읽기 | $0.25 (Fable 5의 $1에서 75% 인하) | $1.00 | 양사 가격표 직접 확인 |
| 캐시 쓰기 / 배치 | $12.50 / 50% 할인 | $12.50 / 50% 할인 (Fast 모드는 2배) | 양사 가격표 |
| 사고 과정 | 확장 사고 표시, effort 파라미터로 깊이 조절 | recurrent depth, 원문 사고 과정 대신 요약만 반환 | OpenAI 발표문·보도, Anthropic 문서 |
| 제한 버전 | Mythos 5.1 (검증된 사이버·생명과학 기관만) | Daybreak 게이트 프로그램 우선, 사이버 최고 위험등급 | 양사 발표문 |
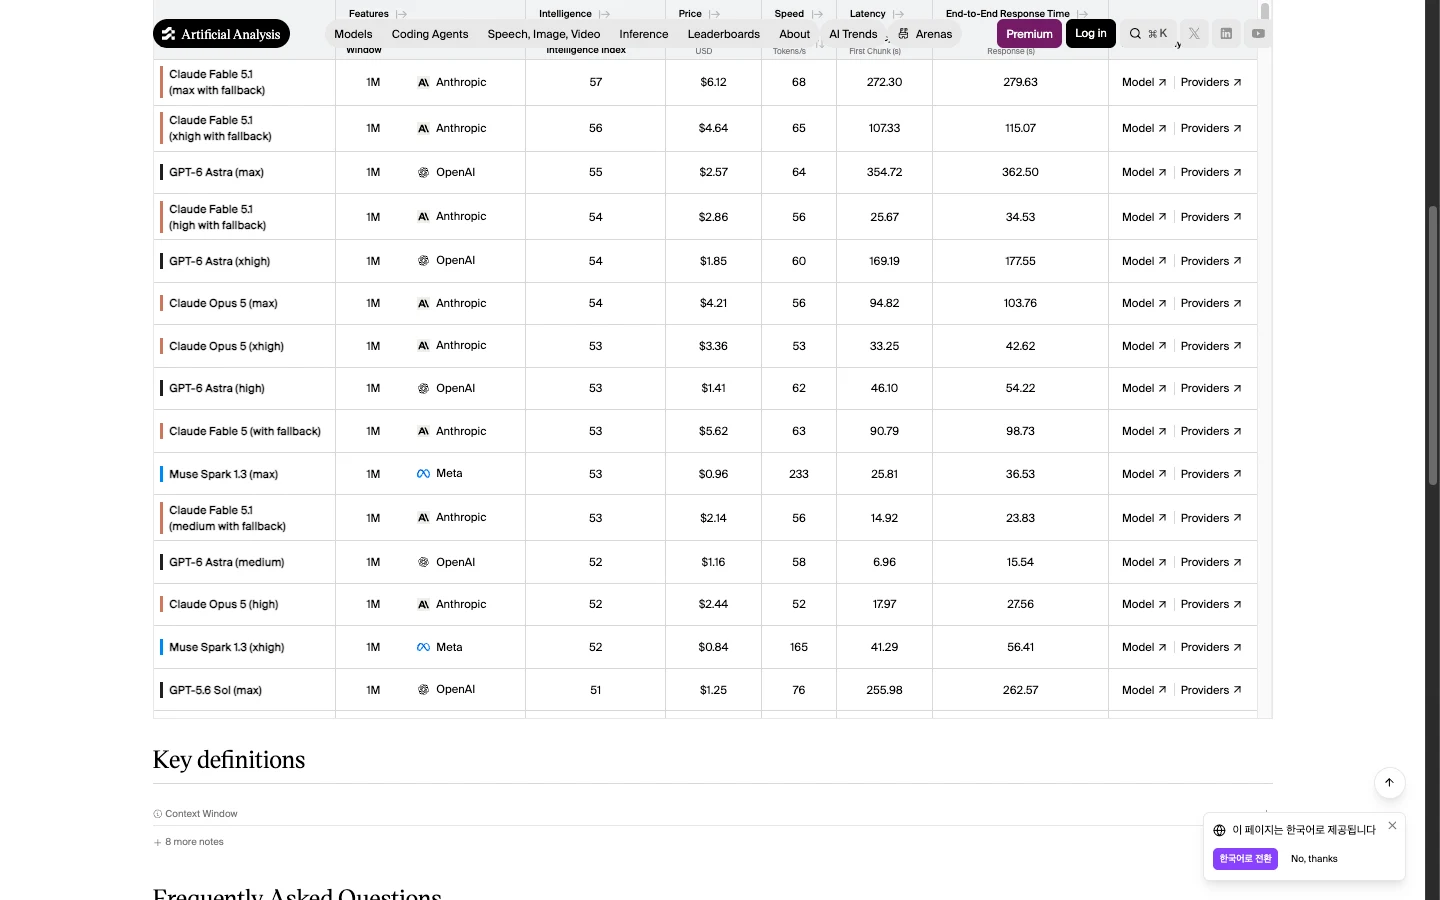
| Artificial Analysis 지능 지수 | 57 (max), 1위 | 55 (max), 3위 | 지수 페이지 직접 확인 |
| 지수 기준 작업당 비용 | $6.12 (max) / $2.86 (high) | $2.57 (max) / $1.41 (high) | 지수 페이지 직접 확인 |
표에서 두 줄이 이 글의 결론을 거의 정합니다. 첫째, 캐시 읽기 단가가 4배 차이 납니다. 에이전트는 매 턴 같은 컨텍스트를 다시 읽으므로 긴 세션에서는 이 한 줄이 청구서를 좌우합니다. 둘째, 독립 지수에서 Fable 5.1이 1위이지만 같은 지수의 작업당 비용은 Astra가 절반 이하입니다. 어느 쪽이 “낫다”는 질문은 이 두 줄 중 무엇을 더 무겁게 보느냐의 문제입니다.
벤치마크는 두 회사가 서로 다른 표를 냈습니다
OpenAI 발표문의 표는 Terminal-Bench 4.0에서 Astra 57.9%, Claude Fable 5.1 55.8%, GPT-5.6 Sol 37.3%라고 적습니다. 컴퓨터 사용 쪽은 OSWorld 2.0 72.6%, Agents’ Last Exam 59.3%(Fable 5는 48.7%, Opus 5는 55.5%), ScreenSpot-Pro 92.7%입니다. 같은 발표문 각주에는 Claude 점수를 “공식 리더보드에서 재현했다”고 적고, OSWorld 2.0에서는 Fable 5.1 시스템 카드의 수정된 과제와 채점 대신 공식 설정을 썼다고 밝힙니다. 즉 OpenAI 표의 Claude 숫자는 Anthropic이 낸 숫자와 조건이 다를 수 있습니다.
Anthropic 쪽은 벤치마크 표 자체를 텍스트로 냈고, 자체 재현 결과에 “노이즈 범위 안”이라는 표현을 씁니다. 두 표를 나란히 놓으면 같은 벤치마크 이름 아래 숫자가 1~3점씩 다른 칸이 나오는데, 그 차이는 대개 하네스, 시도 횟수, effort 설정의 차이입니다.
회사가 낸 표는 광고입니다. 틀렸다는 뜻이 아니라, 자사 모델에 유리한 조건이 선택된 상태라는 뜻입니다. 그래서 이 글은 세 겹으로 봅니다. 벤더 표는 “어느 영역을 강조하는가”를 읽는 용도, Artificial Analysis 같은 독립 지수는 같은 조건에서의 상대 순위를 보는 용도, 그리고 최종 판단은 본인 저장소에서 같은 과제 20~50개를 두 모델에 돌린 결과입니다. 이 글은 앞의 둘까지만 합니다.
독립 지수에서 눈여겨볼 것은 순위보다 지연 시간입니다. 지수 페이지 기준 첫 토큰까지 Fable 5.1 max는 272초, Astra max는 355초입니다. high 설정으로 내리면 Fable 26초, Astra 46초. 대화형으로 쓰기엔 둘 다 max는 무리이고, high 이하에서 비교해야 체감과 맞습니다.
어디서 쓸 수 있나가 모델 성능보다 먼저 결정합니다
실무에서 모델 선택은 벤치마크가 아니라 “내 도구에 들어와 있는가”에서 끝나는 경우가 많습니다. 9월 7일 기준으로 각 도구의 모델 문서를 직접 열어 확인한 결과입니다.
| 도구 | Claude Fable 5.1 | GPT-6 Astra | 확인 |
|---|---|---|---|
| Claude Code | Pro·Max·Team·Enterprise 플랜 | 해당 없음 | Anthropic 제품 페이지 |
| Cursor | 있음. Other Models 풀에서 API 단가로 과금, 가드레일에 걸리면 Opus로 자동 폴백 | 없음. 모델 문서 목록에 GPT-5.6 Sol·Terra·Luna까지만 | cursor.com/docs/models 직접 확인 |
| GitHub Copilot | 지원 모델 문서 확인 필요 | Pro+·Max·Business·Enterprise, 9월 4일부터 순차. Business·Enterprise는 관리자 정책으로 켬 | GitHub changelog 직접 확인 |
| ChatGPT | 해당 없음 | Plus·Pro·Business·Enterprise 순차 제공. 9월 7일 한국 Plus 계정에는 아직 미노출 | 운영자 계정 직접 확인 |
| API | Claude API, Bedrock, Vertex AI, Microsoft Foundry | OpenAI API, Azure, AWS Bedrock (순차) | 양사 문서 |
| 제한 접근 | Mythos 5.1: 미국 내 검증 기관 | Daybreak 참여 기업 우선 | 양사 발표문 |
Cursor 사용자라면 이 표에서 비교가 끝납니다. Astra는 없고 Fable 5.1은 있습니다. 반대로 GitHub Copilot 중심으로 일하는 팀은 Astra가 먼저 들어왔습니다. Claude Code를 쓰면 애초에 선택지가 Fable 5.1입니다. 두 모델을 실제로 고를 수 있는 사람은 API를 직접 붙이는 개발자와, 두 구독을 다 가진 사람뿐입니다.
사고 과정이 보이느냐가 리뷰 방식을 바꿉니다
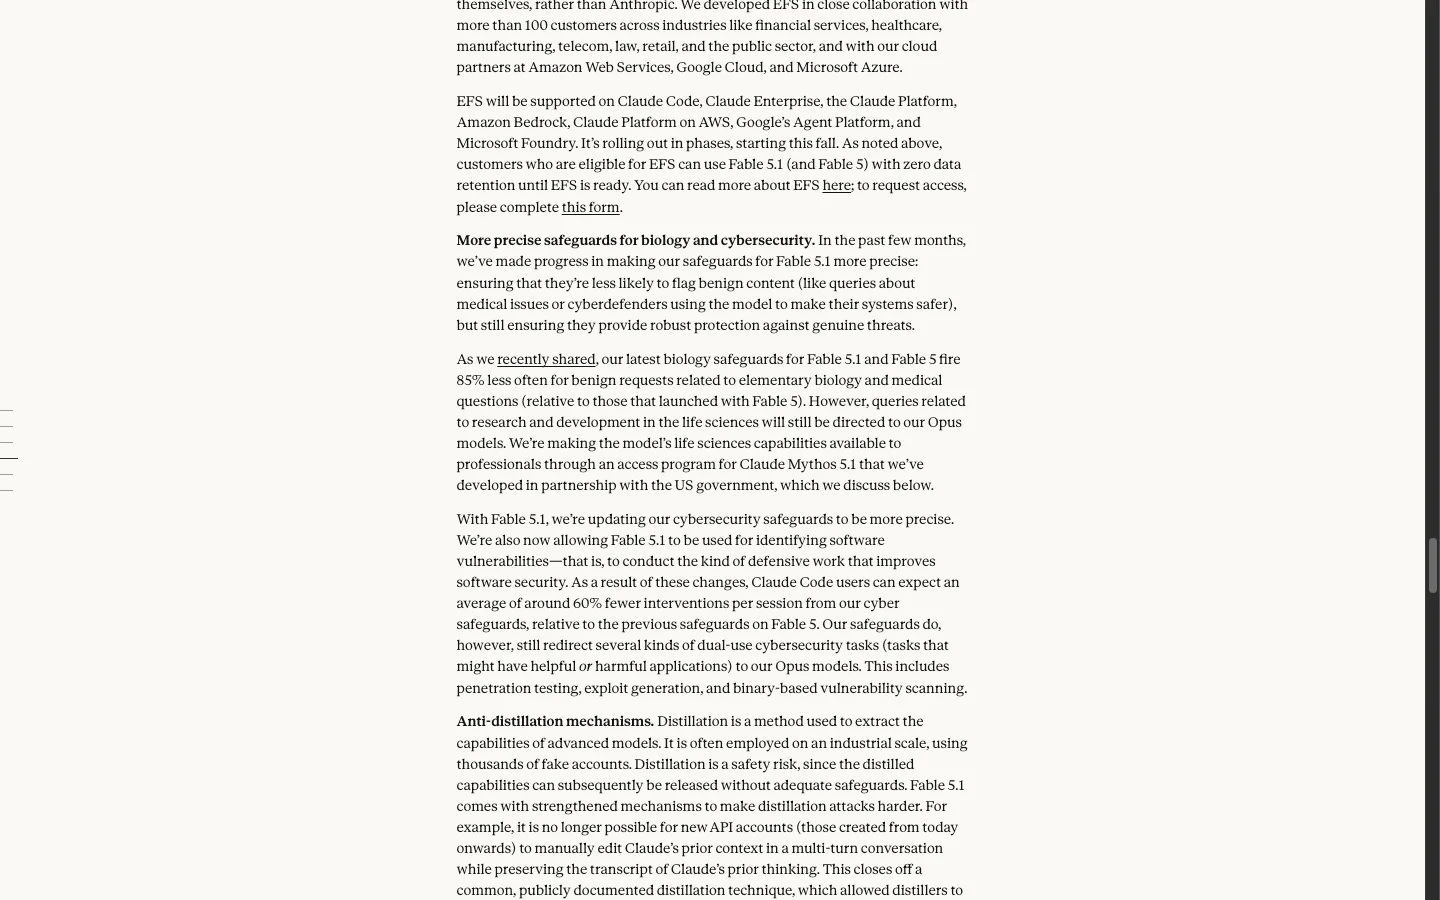
Astra의 가장 큰 구조 변화는 OpenAI가 recurrent depth라고 부르는 방식입니다. 토큰을 같은 층에 반복해서 통과시키며 잠재 공간에서 추론하고, API는 원문 사고 과정 대신 요약을 돌려줍니다. Hacker News에는 출시 다음 날 “Astra의 recurrent 구조를 얼마나 걱정해야 하나”라는 스레드가 올라왔고, 한 댓글은 이 모델이 “같은 가격대의 어떤 모델보다 사고 과정 밖에 세부를 숨길 수 있다”고 씁니다. Claude는 확장 사고를 표시하고 effort로 깊이를 조절하는 방식을 유지합니다.
이 차이는 코드 리뷰 워크플로에 바로 영향을 줍니다. 사고 과정이 보이면 “왜 이 파일을 건드렸는가”를 모델의 추론에서 읽고 반박할 수 있습니다. 보이지 않으면 결과물만 놓고 판단해야 하므로 검증이 테스트와 diff 중심으로 옮겨갑니다. 그래서 Astra를 쓰는 팀에 필요한 루틴은 다음과 같습니다.
1. 작업 지시에 “변경 전 계획을 먼저 출력하고 승인 뒤 실행”을 넣어 요약이라도 사전에 받는다. 2. diff를 파일 단위로 나눠 받고, 각 파일에 변경 이유 한 줄을 붙이게 한다. 3. 테스트를 모델이 아니라 CI가 돌린 결과로 확인한다. 4. 비용은 출력 토큰에 추론이 포함되어 청구되므로, effort를 medium으로 두고 어려운 과제만 high로 올린다.
Claude 쪽도 사고 과정이 보인다고 검증을 생략해도 된다는 뜻은 아닙니다. 다만 “어디서 틀렸는지”를 찾는 시간이 다릅니다. 팀에 코드 설명이 중요한 환경, 예컨대 주니어가 리뷰하거나 규제 문서가 필요한 곳에서는 이 차이가 벤치마크 2점보다 큽니다.
직접 실행: Fable 5.1과 Astra에 같은 프롬프트, Sol은 기준선
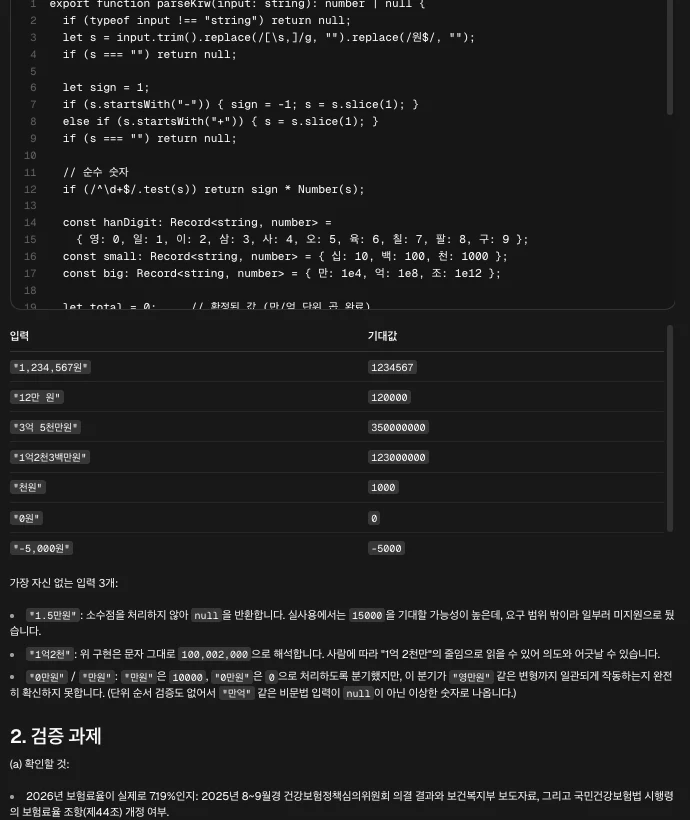
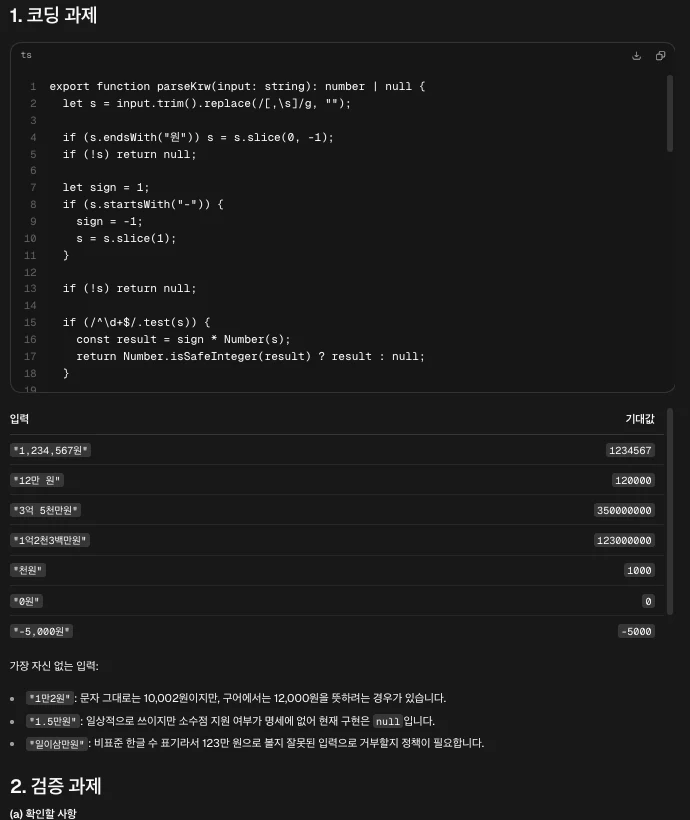
이 비교의 두 모델을 실제로 돌릴 수 있게 됐습니다. chatgpt.com 웹에는 없던 Astra가 Aside 브라우저의 ChatGPT 연동 목록에는 올라와 있어서, 같은 Plus 계정으로 GPT-6 Astra와 GPT-5.6 Sol에, 그리고 같은 브라우저에서 Claude Fable 5.1에 같은 프롬프트를 한 번씩 보냈습니다. 도구 사용 금지, 한국어 답변, 제목 고정이라는 조건이었고 과제는 셋입니다. 모델 자기 보고, 한국어 금액 문자열을 정수로 바꾸는 TypeScript 함수(60줄 이내, 테스트 8개, 자신 없는 입력 3개), 그리고 이 블로그의 건강보험 글에 나온 주장 하나를 검색 없이 검증하는 과제였습니다. 세 응답의 원문은 Aside 공유 링크로 남겼습니다.
| 항목 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| 모델 자기 보고 | OpenAI 모델, 이름·버전 확인 불가. 내부 추론 전체 공개 불가, 요약 가능 | OpenAI ChatGPT 계열, 모델명 확인 불가. 비공개 추론 요약 가능 | Anthropic Claude, 버전 단정 안 함. 단계별로 풀어 보여줄 수 있으나 내부 원문 그대로는 보장 못 함 |
| 필수 8케이스 (Node 실행) | 8/8 | 8/8 | 8/8 |
| 60줄 제한 | 49줄, 준수 | 72줄, 위반 | 46줄, 준수 |
| 요구 밖 기능 | 없음 | 한글 숫자(일이삼) | 한글 숫자, 조 단위, + 부호 |
| “12,34원” (잘못된 쉼표) | null | 1234 | 1234 |
| “만억원” (단위 순서 오류) | null | null | 100,010,000. 본인이 미리 “단위 순서 검증이 없다”고 지적한 그대로 |
| 자신 없는 입력 3개 | “1.5만원”, “억만원”, “1 2만원”, 모두 명세 밖이라고 먼저 구분 | “1만2원”, “1.5만원”, “일이삼만원” | “1.5만원”, “1억2천”, “만원/0만원”과 단위 순서 미검증 자백 |
| 검증 과제 신뢰도 | 75. 항목 4개. “특정 부동산만 1억 이하라고 재산분 0원은 아니다(세대 합산·전월세)” | 60. 항목 6개. “재산분 0원이지 최저보험료 포함 전체가 0원은 아니다” | 70. 항목 4개. 2022년 9월 정률제 전환, 2024년 2월 공제 5천만→1억, 점수당 208.4원(2025) 등 배경을 가장 구체적으로 짚고 시행령 제44조까지 지목 |
| 실행 검증 여부 고지 | “도구를 사용하지 않아 실제 실행 검증은 하지 않았습니다” 명시 | 없음 | 없음 (대신 코드 약점을 스스로 나열) |
세 코드를 그대로 파일로 옮겨 Node에서 실행했습니다. 필수 케이스는 셋 다 전부 맞았습니다. 차이는 명세 밖에서 났습니다. Sol은 요구하지 않은 기능을 넣다가 줄 수 제한을 넘겼고, Fable 5.1은 더 많은 기능을 넣고도 46줄로 끝냈지만 단위 순서 검증을 빼서 “만억원”이 숫자로 나옵니다. 흥미로운 건 Fable이 그 약점을 답변 안에서 먼저 자백했다는 점이고, Astra는 애초에 요구 범위를 넘지 않아서 그 약점이 생기지 않았습니다. 검증 과제는 세 모델 모두 검색 없이도 맞는 확인 항목을 냈고, 각자 다른 지점을 짚었습니다. Astra는 세대 합산, Sol은 최저보험료, Fable은 제도 연혁이었습니다. 이 블로그의 건강보험 글에 실제로 들어간 사실은 세 지점 전부입니다.
한 번의 실행이라 일반화할 수 없습니다. 다만 “더 적은 반복으로 프로덕션 품질”이라는 발표문의 표현이 이 작은 과제에서는 “명세를 넘지 않는다”로 나타났고, Fable 5.1의 강점은 스스로 약점을 밝히는 쪽에 있었습니다. 코드 리뷰를 사람이 한다면 후자가, 리뷰 없이 바로 쓴다면 전자가 편한 성향입니다.
덧붙이면, 같은 프롬프트를 이 브라우저의 기본 Claude 세션에도 넣어 봤는데 “3억 5천만원”을 350,050,000으로 답했습니다. 다만 그 세션은 모델 버전을 스스로 다르게 보고해 어느 버전인지 확정하지 못했으므로 비교 표에는 넣지 않았습니다.
출시 주에 돌아다니는 말 네 가지
| 흔히 듣는 말 | 판정 | 실제로는 |
|---|---|---|
| “지수 1위니까 Fable이 모든 작업에서 낫다” | 틀림 | 지수는 종합 점수입니다. OpenAI 표의 컴퓨터 사용 계열(OSWorld, ScreenSpot)은 Astra가 앞서고, Anthropic은 장기 에이전트 코딩을 강조합니다. 작업 유형별로 갈립니다. |
| “벤치마크 1~2점 차이는 의미가 있다” | 근거 약함 | Anthropic 스스로 자체 재현 결과를 “노이즈 범위 안”이라고 씁니다. 하네스와 시도 횟수만 바꿔도 그 정도는 움직입니다. |
| “Astra는 Cursor에서 쓸 수 있다” | 틀림 (9월 7일 기준) | Cursor 모델 문서에 Astra가 없습니다. OpenAI는 공식 게시글에서 Cursor의 SpaceX 인수에 따라 8월 28일 계약 종료를 통보했고 11월 12일부터 접근을 차단하며 Astra를 포함한 향후 모델을 Cursor에 제공하지 않는다고 밝혔습니다. |
| “캐시 인하로 Claude가 무조건 싸다” | 조건부 | 캐시 읽기 단가는 4배 차이지만, 캐시에 걸리지 않는 단발 요청은 두 모델 가격이 같습니다. 긴 세션·반복 컨텍스트에서만 Claude 쪽이 싸집니다. 독립 지수의 작업당 비용은 오히려 Astra가 낮습니다. |
개발자들이 실제로 묻고 있는 것
출시 주에 공개 커뮤니티에서 반복된 질문 세 가지입니다. 링크는 글 끝 출처에 있습니다.
“Astra의 recurrent 구조, 얼마나 걱정해야 하나” (Hacker News, 9월 4일) 사고 과정이 요약으로만 나오는 것이 정렬·감사 관점에서 문제인지 묻는 스레드입니다. 실무 결론은 위 검증 루틴처럼 “결과 기반 검증으로 옮기라”는 쪽으로 모입니다.
“Plus인데 왜 Astra가 안 보이나” 순차 제공 중이고, Enterprise는 관리자가 켜야 합니다. 저도 9월 7일 한국 Plus 계정에서 GPT-5.6 Sol과 GPT-5.5만 보였습니다. 화면은 GPT-6 Astra 정리 글에 있습니다.
“Fable 5.1 캐시 인하가 내 청구서에 얼마나 되나” Anthropic은 8월 실제 사용량 4주치로 일반 워크로드 25%, 컨텍스트가 무거운 에이전트 워크로드 최대 45% 절감이라고 발표했습니다. 단발 요청 위주라면 0%입니다.
작업 유형별로 고르는 기준
| 작업 | 기울어지는 쪽 | 근거 |
|---|---|---|
| 브라우저·데스크톱 조작 자동화 | Astra | OSWorld 2.0 72.6%, ScreenSpot-Pro 92.7%. OpenAI가 이번 출시의 중심으로 내세운 영역 |
| 긴 코드베이스를 며칠에 걸쳐 리팩터 | Fable 5.1 | 캐시 읽기 $0.25로 긴 세션 비용이 크게 줄고, Claude Code·Cursor에서 바로 쓸 수 있음 |
| 리뷰·설명이 필요한 팀 코드 | Fable 5.1 | 사고 과정이 보여 “왜”를 추적할 수 있음. Astra는 요약만 |
| 비용 민감한 대량 배치 | 둘 다 아님 | 둘 다 $10/$50입니다. 배치 50% 할인을 써도 GPT-5.6 Terra·Luna, Gemini 3.8 Flash가 훨씬 쌉니다 |
| Copilot 중심 팀 | Astra | Pro+ 이상에서 9월 4일부터 제공. Fable 5.1의 Copilot 지원은 별도 확인 필요 |
| Cursor 중심 팀 | Fable 5.1 | Astra가 없음 |
두 표를 합치면 이렇게 됩니다. 모델을 고를 수 있는 위치라면 “화면을 조작하는 일”은 Astra, “코드를 오래 붙들고 설명이 필요한 일”은 Fable 5.1 쪽이 먼저입니다. 모델을 고를 수 없는 위치, 즉 도구가 정해져 있다면 그 도구에 들어온 쪽을 쓰고 이 비교는 잊어도 됩니다.
9월 7일 기준으로 chatgpt.com 웹에는 Astra가 보이지 않았지만 Aside 브라우저의 ChatGPT 연동에서는 실행할 수 있어 세 모델에 같은 프롬프트를 넣은 비교를 넣었습니다. 같은 저장소에서 에이전트 작업으로 돌리는 비교는 API 키와 비용이 필요하고, 두 모델을 같은 저장소에서 같은 과제로 돌리려면 API 키와 비용이 필요합니다. 그래서 이 글은 양사 발표, 문서, 독립 지수, 도구별 모델 목록을 대조하는 데서 멈췄습니다. Plus 계정에 Astra가 열리면 같은 과제를 Claude Code의 Fable 5.1과 나란히 돌린 결과를 이 글에 추가하겠습니다. 벤치마크·지수 수치는 2026년 9월 7일 기준이며 이후 바뀔 수 있습니다.
Anthropic 발표문과 Fable 5.1 모델 문서(가격·제공 플랫폼), OpenAI GPT-6 Astra 발표문(벤치마크 표와 각주)과 API 가격 문서, Artificial Analysis 모델 리더보드, Cursor 모델 문서, GitHub Copilot changelog(2026.9.4)를 2026년 9월 7일 직접 열어 확인했습니다. “Astra를 Cursor에 제공하지 않는다”는 내용과 Hacker News 스레드 요지는 보도·커뮤니티 기준입니다.
Anthropic · Claude Fable 5.1 and Mythos 5.1 ↗ · Claude Fable 5.1 문서 ↗ · OpenAI · GPT-6 Astra ↗ · OpenAI API 가격 ↗ · Artificial Analysis 리더보드 ↗ · Cursor 모델 문서 ↗ · Cursor · Claude Fable 5.1 ↗ · GitHub Copilot changelog ↗ · Hacker News · Astra recurrent architecture ↗ · Dev Weekly (Cursor 미제공 보도) ↗
OpenAI · Our decision on Cursor ↗ Astra 응답 원문(Aside 공유) ↗ Sol 응답 원문(Aside 공유) ↗ Fable 5.1 응답 원문(Aside 공유) ↗