30초 요약: 순서를 지키면 같은 모델로 절반이 됩니다
1. 캐싱은 손익분기가 문서에 명시돼 있습니다. 5분 캐시는 읽기 1회부터, 1시간 캐시는 2회부터 이득입니다. 그 아래로 재사용되면 오히려 손해입니다.
2. 배치는 입력·출력 모두 50% 할인이고 조건은 “기다릴 수 있는가” 하나뿐입니다. 쓰던 모델 그대로 반값이 됩니다.
3. 할인은 곱해집니다. 캐시 배수와 배치 할인, 데이터 레지던시 배수가 서로 겹쳐서 적용됩니다.
그리고 시작 전에 알아야 할 함정이 하나 있습니다. Claude 4.7 이후 모델은 토크나이저가 바뀌어 같은 글도 토큰이 약 30% 더 나옵니다. 단가를 그대로 두고 모델만 올렸는데 청구서가 늘었다면 여기가 원인일 수 있습니다.
0. 줄이기 전에 어디서 쓰는지 잽니다
모든 응답에는 usage 필드로 입력·출력 토큰 수가 함께 옵니다. 이걸 요청 유형별로 기록하는 것이 시작입니다. 대부분의 서비스에서 비용은 소수의 요청 유형에 몰려 있고, 어디가 큰지 모르면 엉뚱한 곳을 최적화하게 됩니다.
resp = client.messages.create(model=MODEL, ...)
log.info("llm_usage", extra=dict(
task=task_name, # 요청 유형 태그가 핵심
input=resp.usage.input_tokens,
output=resp.usage.output_tokens))
OpenAI는 response.usage.prompt_tokens와 completion_tokens로 같은 값을 줍니다.
일주일만 모아 합산하면 어디부터 손댈지가 바로 보입니다. 패턴도 단순합니다. 입력이 출력의 열 배가 넘으면 컨텍스트 다이어트와 캐싱이 답이고, 출력이 큰 구조면 응답 길이 제한이 먼저입니다. 이 구분 없이 캐싱부터 붙이면 효과가 안 납니다.
먼저 알아야 할 함정: 토큰 수 자체가 늘었습니다
공식 가격 문서에 이런 주석이 붙어 있습니다. “Claude 4.7 이후 모델과 Claude Mythos Preview는 새로운 토크나이저를 사용하며, 같은 텍스트에 대해 약 30% 더 많은 토큰을 생성한다. 정확한 증가폭은 콘텐츠와 워크로드 형태에 따라 다르다. Claude Sonnet 4.6 이전 모델은 이전 토크나이저를 쓴다.”
즉 단가표만 비교하면 판단을 그르칠 수 있습니다. Sonnet 4.6($3/MTok)에서 Sonnet 5($2/MTok)로 옮기면 단가는 33% 싸지지만, 같은 원문이 토큰을 30% 더 먹으면 실제 절감은 그만큼 깎입니다. 단가 × 토큰 수로 계산해야 하고, 모델을 바꿀 때는 실제 요청 몇 건으로 usage를 찍어 비교하는 편이 정확합니다.
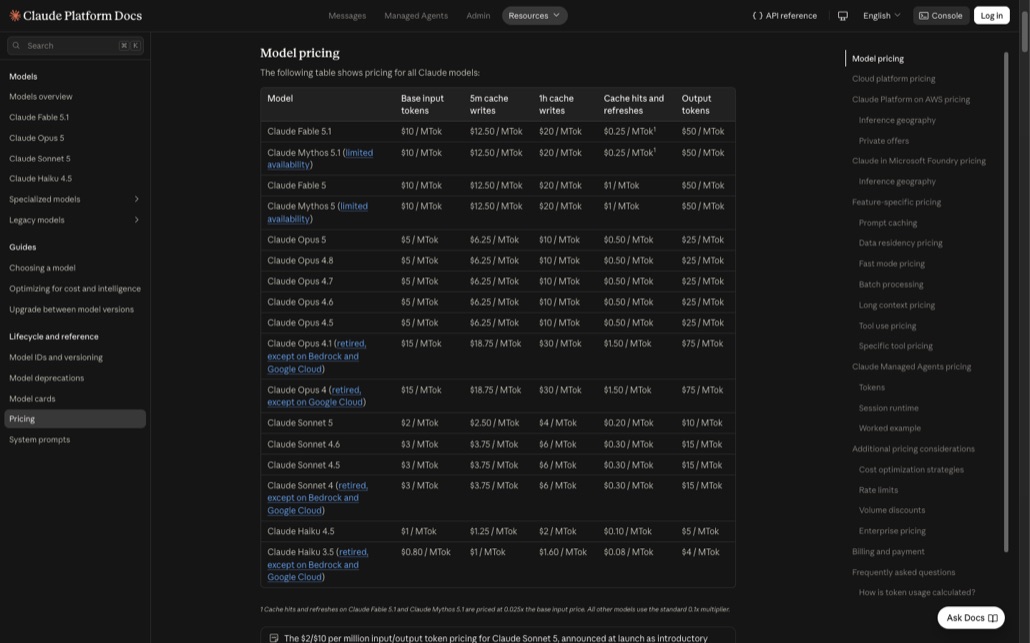
| 모델 | 입력 | 출력 | 캐시 적중 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 (0.025배) |
| Claude Opus 5 | $5 | $25 | $0.50 (0.1배) |
| Claude Sonnet 5 | $2 | $10 | $0.20 (0.1배) |
| Claude Haiku 4.5 | $1 | $5 | $0.10 (0.1배) |
단위는 모두 100만 토큰당 미국 달러입니다. 참고로 Sonnet 5의 $2/$10은 출시 당시 2026년 8월 31일까지의 도입가로 발표됐지만, 문서는 이제 이 값이 표준 가격이며 9월 1일로 예정됐던 $3/$15 인상은 일어나지 않는다고 명시하고 있습니다.
1. 입력에서 반복되는 것을 찾습니다
챗봇처럼 대화 이력을 매번 다시 보내는 구조는 턴이 길어질수록 입력이 눈덩이처럼 커집니다. 오래된 턴은 요약본으로 바꾸거나 최근 몇 턴만 유지하는 식으로 잘라야 합니다. RAG라면 검색 결과를 통째로 넣는 대신 상위 몇 건만 넣고, 문서 전문 대신 관련 구간만 추리는 쪽이 효과가 큽니다.
출력 쪽도 통제 대상입니다. max_tokens는 상한일 뿐이라 실제 길이를 줄이려면 프롬프트로 지시해야 합니다. 구조화된 결과가 필요하면 자연어 설명 대신 정해진 필드로 받는 편이 토큰도 적고 다음 단계 검증도 쉽습니다.
Claude 4.6 이후 모델은 100만 토큰 컨텍스트를 표준 가격으로 제공합니다. 문서 표현으로는 “90만 토큰 요청도 9천 토큰 요청과 같은 토큰당 요율로 청구된다”입니다. 긴 컨텍스트라고 해서 토큰당 단가가 올라가지는 않습니다. 다만 토큰 수 자체가 많아지니 총액은 당연히 커집니다. 캐싱과 배치 할인도 전체 창에 걸쳐 표준 요율로 적용됩니다.
2. 캐싱: 손익분기가 문서에 적혀 있습니다
캐싱은 매 요청 반복되는 프롬프트 앞부분을 저장해 두고 재사용하는 기능입니다. 핵심은 켜는 방법이 아니라 프롬프트를 “고정 부분 앞, 가변 부분 뒤”로 배치하는 설계입니다. 캐시는 접두부 일치로만 작동해서, 앞부분이 한 글자라도 바뀌면 그 지점부터 전부 캐시 실패입니다. 시스템 프롬프트에 현재 시각을 넣는 습관이 대표적인 캐시 파괴 사례입니다.
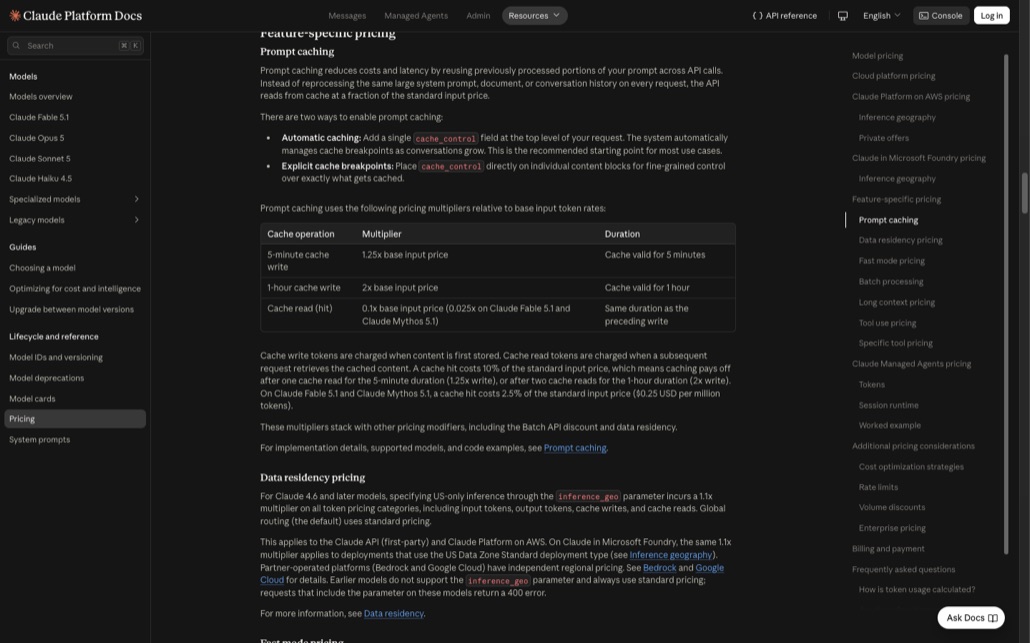
| 캐시 동작 | 배수 | 유효 기간 | 손익분기 |
|---|---|---|---|
| 5분 캐시 쓰기 | 기본 입력가의 1.25배 | 5분 | 5분은 읽기 1회, 1시간은 2회부터 이득 |
| 1시간 캐시 쓰기 | 기본 입력가의 2배 | 1시간 | |
| 캐시 읽기(적중) | 기본 입력가의 0.1배 (Fable 5.1·Mythos 5.1은 0.025배) | 직전 쓰기와 동일 | 표준가의 10% |
여기서 실무 판단이 갈립니다. 같은 프롬프트 앞부분을 5분 안에 두 번 이상 쓸 구조가 아니라면 캐싱은 손해입니다. 반대로 하루 종일 같은 시스템 프롬프트와 도구 정의를 반복하는 에이전트라면 1시간 캐시가 유리합니다. Fable 5.1은 캐시 적중이 0.025배라 예외적으로 재사용 이득이 큽니다. 기본 입력 $10이 캐시 적중 시 $0.25가 되니 40분의 1입니다.
켜는 방식은 두 가지입니다. 요청 최상위에 cache_control 필드 하나를 넣는 자동 캐싱(문서가 대부분의 경우 권하는 출발점)과, 개별 콘텐츠 블록에 직접 붙이는 명시적 브레이크포인트입니다. 처음이라면 자동으로 시작하고, 무엇이 캐시되는지 세밀하게 통제해야 할 때 명시로 넘어가면 됩니다.
3. 배치: 판단 기준은 “화면을 보고 있는가”
Batch API로 보내는 요청은 입력·출력 토큰이 모두 50% 할인됩니다. 대가는 지연입니다. 그래서 도입 판단은 기술이 아니라 업무 분류 문제입니다. 기준은 단순합니다. 사용자가 결과를 기다리며 화면을 보고 있는가. 보고 있다면 배치 대상이 아닙니다. 야간 문서 분류, 대량 요약, 데이터 정제, 백필, 평가 파이프라인처럼 사람이 기다리지 않는 작업이 대상입니다.
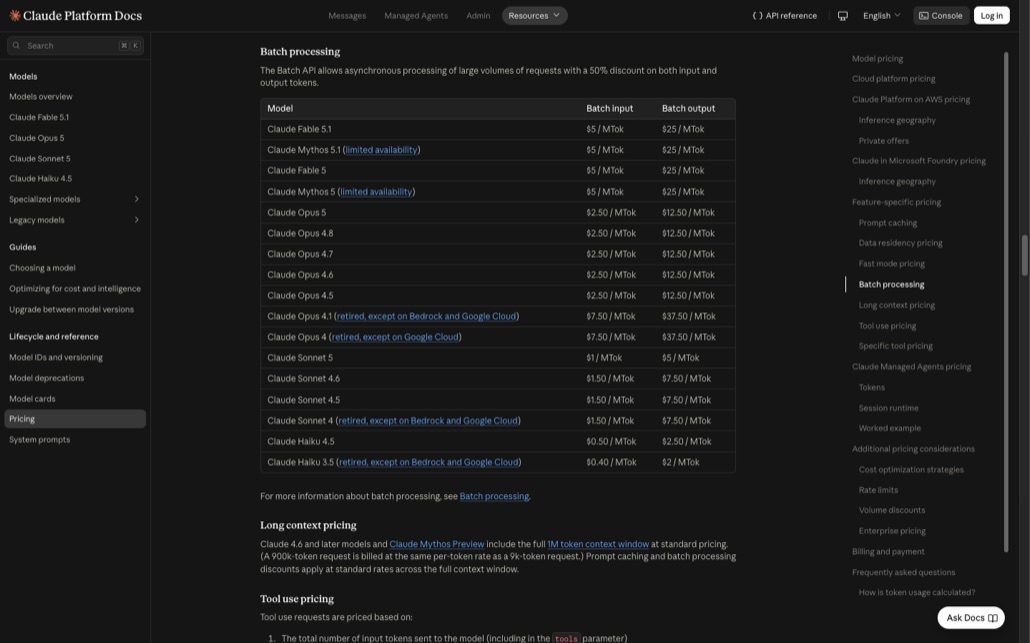
| 모델 | 표준 입력/출력 | 배치 입력/출력 |
|---|---|---|
| Claude Fable 5.1 | $10 / $50 | $5 / $25 |
| Claude Opus 5 | $5 / $25 | $2.50 / $12.50 |
| Claude Sonnet 5 | $2 / $10 | $1 / $5 |
| Claude Haiku 4.5 | $1 / $5 | $0.50 / $2.50 |
서비스 로그를 요청 유형별로 나눠 보면 전체 토큰의 절반 이상이 비실시간 물량인 경우가 흔합니다. 그 물량만 배치로 분리해도 해당 비용이 반이 됩니다. 구현은 요청 여러 건을 각자 고유 ID와 함께 하나의 배치로 제출하고, 처리가 끝난 뒤 결과를 가져오는 방식입니다. 개별 요청이 실패할 수 있으므로 ID 단위로 성공·실패를 대조하는 처리가 반드시 필요합니다.
4. 할인은 곱해집니다 (그리고 배수도 곱해집니다)
가장 놓치기 쉬운 문장이 캐싱 섹션 끝에 있습니다. “이 배수들은 Batch API 할인과 데이터 레지던시를 포함한 다른 가격 수정자와 겹쳐 적용된다.”
좋은 방향으로는, 배치로 보내는 요청에도 캐시 적중 할인이 함께 붙습니다. 나쁜 방향으로도 작동합니다. Claude 4.6 이후 모델에서 inference_geo로 미국 내 추론을 지정하면 모든 토큰 항목에 1.1배가 붙습니다. 입력·출력만이 아니라 캐시 쓰기와 캐시 읽기까지 전부입니다. 기본값인 글로벌 라우팅은 표준 가격입니다. 이전 모델에 이 파라미터를 넣으면 400 오류가 반환됩니다.
규제 때문에 미국 내 추론이 필요하다면전체 비용에 1.1배를 곱해 예산을 잡으세요. 캐싱으로 아낀 뒤에 곱해지므로 절대 증가폭 자체는 줄어듭니다.
그런 요구가 없다면inference_geo를 건드리지 마세요. 기본값이 가장 쌉니다.
배치와 캐싱 중 뭘 먼저 붙일지 고민이라면업무 분류만 하면 되는 배치가 먼저입니다. 캐싱은 프롬프트 구조를 고쳐야 해서 손이 더 갑니다.
5. 모델 티어링은 마지막입니다
여기까지 하고도 부족하면 그때 모델을 나눕니다. 분류·추출·라우팅처럼 판단이 단순한 단계는 Haiku 4.5($1/$5)로 내리고, 최종 생성이나 복잡한 추론만 상위 모델에 남기는 식입니다. Haiku와 Opus 5는 입력·출력 모두 5배 차이라 물량이 많은 전처리 단계를 내리는 것만으로 체감이 큽니다.
다만 앞 단계를 건너뛰고 여기부터 손대면 처음의 문제로 돌아갑니다. 구조가 그대로면 싼 모델로 옮겨도 입력이 계속 부풀어 비용이 다시 커집니다. 그리고 앞서 말한 토크나이저 차이 때문에, 모델을 바꿀 때는 단가표가 아니라 usage 실측으로 비교해야 합니다.
자주 묻는 질문
캐싱과 배치를 같이 쓸 수 있나요?
네. 공식 문서가 배수들이 서로 겹쳐 적용된다고 명시합니다. 배치로 보낸 요청에도 캐시 적중 할인이 붙습니다.
캐시를 켰는데 비용이 줄지 않습니다.
접두부가 매 요청 달라지고 있을 가능성이 큽니다. 시스템 프롬프트 안의 현재 시각, 요청 ID, 사용자 이름처럼 매번 바뀌는 값을 앞부분에서 빼고 뒤쪽 사용자 메시지로 옮기세요. 그리고 5분 안에 두 번 이상 재사용되지 않으면 애초에 손익분기를 못 넘깁니다.
배치 결과는 얼마나 기다려야 하나요?
비동기 처리라 즉시 응답이 아니며, 물량과 상황에 따라 달라집니다. 사용자가 기다리는 화면에는 쓸 수 없다는 전제로 설계하세요.
긴 컨텍스트를 쓰면 단가가 올라가나요?
Claude 4.6 이후 모델은 아닙니다. 문서가 “90만 토큰 요청도 9천 토큰 요청과 같은 토큰당 요율”이라고 밝힙니다. 토큰당 요율은 같고, 토큰 수가 많아 총액이 커지는 것입니다.
OpenAI나 Gemini도 같은 원리인가요?
절감 순서(측정 → 입력 줄이기 → 캐싱 → 배치 → 모델 분리)는 같습니다. 다만 배수와 손익분기 숫자는 회사마다 다르므로 이 글의 수치를 그대로 옮기지 마세요. 이 글의 표는 전부 Anthropic 기준입니다.
2026년 9월 15일 Anthropic 공식 가격 문서(platform.claude.com/docs/en/about-claude/pricing)의 모델 단가표, Batch processing 단가표, Prompt caching 배수표와 손익분기 설명, Long context pricing, Data residency pricing, 그리고 토크나이저 변경 주석을 직접 열어 확인했습니다. 실제 청구서로 절감폭을 검증한 사례 비교는 포함하지 않았습니다.