30초 요약: 용량이 아니라 예산의 문제입니다
1. 규칙 네 줄짜리 빈 프로젝트인데도 대화 시작 시점에 이미 Opus 5는 16.5k, Sonnet 5는 30.8k 토큰이 차 있었습니다. 같은 프로젝트, 같은 도구인데 모델만 바꾼 결과입니다.
2. CLAUDE.md를 네 줄에서 242줄로 늘리자 해당 항목이 27토큰에서 5.7k 토큰으로 뛰었습니다. 공식 문서가 “200줄 아래로”라고 적어 둔 이유가 여기서 보입니다.
3. --autocompact 100000으로 창을 좁히면 압축 버퍼 33k가 그대로 남아 전체의 33%를 차지합니다. 실제로 쓸 수 있는 공간은 50.5k, 절반뿐이었습니다.
Anthropic은 컨텍스트를 “한정된 자원(finite resource)”이라고 부릅니다. 창이 커진 것과 모델이 그 안의 내용을 잘 쓰는 것은 다른 문제라는 뜻입니다. 아래는 그 주장을 제 환경에서 숫자로 확인해 본 과정입니다.
컨텍스트 엔지니어링은 프롬프트 엔지니어링의 다음 단계입니다
용어부터 정리하겠습니다. Anthropic 엔지니어링 블로그의 2025년 9월 29일 글 “Effective context engineering for AI agents”가 둘을 이렇게 구분합니다.
| 프롬프트 엔지니어링 | 컨텍스트 엔지니어링 | |
|---|---|---|
| 공식 정의 | “최적의 결과를 위해 LLM 지시문을 쓰고 조직하는 방법” | “추론 중에 최적의 토큰 집합을 선별하고 유지하는 전략 일체” |
| 대상 | 내가 쓰는 프롬프트, 특히 시스템 프롬프트 | 프롬프트 밖에서 들어오는 것까지 포함한 컨텍스트 전체 |
| 성격 | 한 번 잘 쓰면 되는 단발 작업 | 매 추론마다 무엇을 넣을지 다시 정하는 반복 작업 |
핵심은 마지막 줄입니다. 원문은 “프롬프트를 쓰는 단발성 작업과 달리, 컨텍스트 엔지니어링은 반복적이며 선별 단계가 모델에 무엇을 넘길지 정할 때마다 매번 일어난다”고 적습니다. 그래서 이 일은 프롬프트 파일을 잘 써 두는 것으로 끝나지 않고, 세션이 굴러가는 내내 관리 대상이 됩니다.
그리고 목표는 분명합니다. 같은 글은 좋은 컨텍스트 엔지니어링을 “원하는 결과가 나올 확률을 최대로 만드는, 신호가 높은 토큰의 가능한 가장 작은 집합을 찾는 것”이라고 정의합니다. 많이 넣는 게 아니라 적게 넣는 쪽이 목표라는 말입니다.
왜 적게 넣어야 하나: 컨텍스트 로트와 어텐션 예산
같은 글이 근거로 드는 개념이 컨텍스트 로트(context rot)입니다. 원문 표현으로는 “컨텍스트 창의 토큰 수가 늘어날수록 모델이 그 안의 정보를 정확히 회상하는 능력은 떨어진다”이고, “모델마다 저하 정도는 다르지만 이 특성은 모든 모델에서 나타난다”고 덧붙입니다.
이유는 구조에 있습니다. 트랜스포머는 모든 토큰이 다른 모든 토큰을 참조할 수 있게 만들어져 있어서, 토큰 n개면 n²개의 쌍 관계가 생깁니다. 컨텍스트가 길어지면 그 관계를 붙잡는 능력이 얇게 펴지고, 글의 표현대로 “컨텍스트 크기와 주의 집중 사이에 자연스러운 긴장”이 생깁니다. Anthropic은 이걸 사람의 작업기억에 빗대 “어텐션 예산(attention budget)”이라고 부르고, 토큰 하나가 들어올 때마다 그 예산이 조금씩 깎인다고 설명합니다.
여기까지가 문서의 주장입니다. 그럼 내 환경에서 그 예산이 실제로 얼마나 남아 있는지 세어 보겠습니다.
규칙 네 줄짜리 빈 프로젝트에서 /context를 돌렸습니다
측정 환경부터 밝힙니다. 임시 폴더에 index.js 한 줄과 아래 CLAUDE.md만 두고, 개인 설정이 섞이지 않도록 CLAUDE_CONFIG_DIR을 그 폴더 안의 빈 디렉터리로 지정했습니다. 그래야 제가 평소 쓰는 스킬과 서브에이전트가 빠지고 기본값만 남습니다.
mkdir ctx-demo && cd ctx-demo
export CLAUDE_CONFIG_DIR=$PWD/.cfg
claude -p "/context"
슬래시 명령이지만 -p 비대화 모드에서도 표가 그대로 출력됩니다. 결과를 파일로 남겨 비교하기 좋습니다.
CLAUDE.md는 딱 네 줄이었습니다. 제목 한 줄, 커밋 규칙 한 줄, 테스트 명령 한 줄. 결과는 이렇습니다.
| 항목 | 토큰 | 지금 로드되나 |
|---|---|---|
| System prompt | 3k | 예 |
| System tools | 11.6k | 예 |
| System tools (deferred) | 15.6k | 아니요 |
| Memory files (내 CLAUDE.md) | 27 | 예 |
| Skills(기본 제공 12개의 설명문) | 1.8k | 예 |
| Autocompact buffer | 33k | 예약 |
| 합계 표시 | 16.5k / 1m (2%) |
표를 처음 봤을 때 숫자가 안 맞아 보였습니다. 항목을 다 더하면 32k인데 상단 표시는 16.5k였으니까요. 답은 deferred에 있습니다. 지연 등록된 도구 15.6k는 이름만 올라가 있고 스키마 본문은 필요할 때 불러옵니다. 실제로 지금 차 있는 건 3k + 11.6k + 27 + 1.8k = 약 16.4k이고, 표시값과 맞습니다. Haiku로 바꿔 계산해도 6.8k + 20.3k + 20 + 1.4k = 28.5k로 정확히 떨어졌습니다.
이 구조는 공식 문서의 설명과도 맞습니다. Claude Code 문서의 “Explore the context window” 페이지는 세션 시작 직후 무엇이 자동으로 올라가는지를 시뮬레이션으로 보여 주는데, MCP 도구를 “deferred”로 표시하고 “기본적으로 전체 스키마는 지연 상태로 두고 작업에 필요할 때 도구 검색으로 불러온다”고 적어 둡니다.
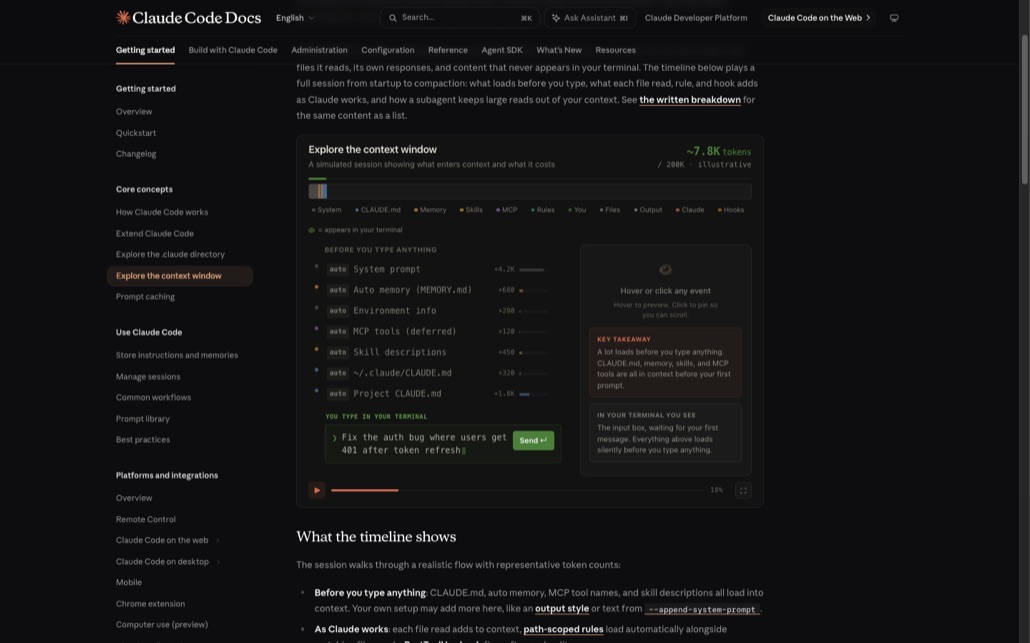
문서 쪽 예시는 200k 창 기준에 자동 메모리와 전역 CLAUDE.md까지 포함해 7.8k입니다. 제 측정이 더 큰 이유는 도구 목록이 실제 설치본 기준으로 잡히고, 기본 제공 스킬 12개의 설명문이 함께 올라가기 때문입니다. 요점은 값의 크기가 아니라 “입력하기 전에 이미 차 있다”는 구조입니다.
모델만 바꿔도 고정비가 거의 두 배 차이 납니다
여기서 예상 밖의 결과가 나왔습니다. 프로젝트도 도구도 그대로 두고 --model만 바꿔 네 번 측정했습니다.
| 모델 | 창 | 시작 시점 사용량 | 시스템 프롬프트 | 시스템 도구 | 지연 도구 |
|---|---|---|---|---|---|
| claude-opus-5 | 1M | 16.5k (2%) | 3k | 11.6k | 15.6k |
| claude-fable-5-1 | 1M | 17.5k (2%) | 3.9k | 11.7k | 15.6k |
| claude-sonnet-5 | 1M | 30.8k (3%) | 9.1k | 19.8k | 16.7k |
| claude-haiku-4-5 | 200k | 28.5k (14%) | 6.8k | 20.3k | 21k |
같은 빈 프로젝트에서 Sonnet 5는 Opus 5의 약 1.9배를 쓰고 시작합니다. 시스템 프롬프트가 3k 대 9.1k로 세 배, 도구 정의가 11.6k 대 19.8k입니다. 모델마다 붙는 기본 지시문과 도구 설명의 분량이 다르다는 뜻입니다.
실무에서 더 중요한 건 마지막 줄입니다. Haiku는 절대값(28.5k)이 Sonnet보다 작은데도 창이 200k라서 시작하자마자 14%가 사라집니다. “싼 모델로 돌리면 되겠지”라고 생각하고 Haiku에 큰 파일 탐색을 맡기면, 남은 171.5k가 생각보다 빨리 바닥납니다. 1M 창 모델에서 같은 작업이 2%만 먹고 시작하는 것과는 체감이 다릅니다.
긴 탐색·대량 파일 읽기가 있는 작업이라면1M 창 모델(Opus 5, Sonnet 5, Fable 계열)로 두는 편이 안전합니다. 고정비 차이보다 창 크기 차이가 훨씬 큽니다.
짧고 반복적인 작업을 싸게 돌리려면Haiku도 괜찮지만, 14%를 깔고 시작한다는 걸 계산에 넣으세요. 파일 읽기는 서브에이전트에 넘기는 편이 낫습니다.
같은 1M 창 안에서 고르는 중이라면고정비는 Opus 5가 가장 가볍고 Sonnet 5가 가장 무겁습니다. 다만 14k 차이는 100만 중 1.4%라 실제 선택 기준으로는 성능과 요금이 먼저입니다.
CLAUDE.md 242줄을 넣자 27토큰이 5.7k가 됐습니다
공식 문서는 CLAUDE.md를 “200줄 아래로 유지하고, 참고성 내용은 스킬이나 경로 한정 규칙으로 옮겨 필요할 때만 로드되게 하라”고 권합니다. 그 권고가 토큰으로 얼마인지 궁금해서, 같은 프로젝트의 CLAUDE.md를 규칙 240줄짜리로 바꿔 다시 측정했습니다.
| CLAUDE.md | Memory files 항목 | 차이 |
|---|---|---|
| 4줄 (제목 + 규칙 2개) | 27토큰 | 세션 총량 16.5k |
| 242줄 (규칙 240개) | 5.7k 토큰 | 세션 총량 22.1k |
5.7k라는 값 자체는 100만 창에서 0.6%라 대단해 보이지 않습니다. 문제는 성격입니다. 이건 매 요청마다 다시 실리는 고정비이고, 압축이 일어난 뒤에도 디스크에서 그대로 재주입됩니다. 대화가 길어질수록 절약되는 게 아니라 계속 따라붙습니다. 게다가 문서는 분량이 길어지면 “지시 준수율이 떨어진다”고도 적어 둡니다. 토큰보다 이쪽이 더 아픈 대가입니다.
반대로 스킬은 설계가 다릅니다. 제 측정에서 기본 제공 스킬 12개가 차지한 건 1.8k인데, 이건 각 스킬의 설명 한 줄씩입니다. 본문은 Claude가 그 스킬을 실제로 쓸 때만 올라옵니다. 그래서 “가끔 필요한 긴 절차”는 CLAUDE.md가 아니라 스킬에 두라는 권고가 나옵니다.
창을 좁히면 압축 버퍼가 3분의 1을 먹습니다
측정표에 계속 등장하는 Autocompact buffer 33k가 무엇인지 확인해 봤습니다. 공식 문서는 1M 창을 쓰는 모델이 “창이 다 차기 전, 기본값으로 약 967K 토큰에서 압축한다”고 적습니다. 100만에서 967k를 빼면 33k입니다. 제가 본 33k가 바로 그 여유분이었습니다.
그럼 창을 좁히면 어떻게 될까요. --autocompact 100000으로 100k를 지정하고 같은 측정을 했습니다.
| 설정 | 표시 | Free space | Autocompact buffer |
|---|---|---|---|
| 기본 (1M) | 16.5k / 1m (2%) | 950.5k (95.0%) | 33k (3.3%) |
| --autocompact 100000 | 16.5k / 100k (17%) | 50.5k (50.5%) | 33k (33.0%) |
버퍼는 33k로 그대로입니다. 창만 10분의 1로 줄었으니 비율이 3.3%에서 33%로 뛰었습니다. 여기에 고정비 16.5k를 더하면, 실제로 대화와 파일 읽기에 쓸 수 있는 공간은 50.5k. 절반입니다. “압축을 자주 시켜 요약을 깔끔하게 유지하자”는 의도로 창을 좁히면, 압축이 잦아지는 대신 한 번에 다룰 수 있는 양이 생각보다 훨씬 작아집니다. 문서가 허용하는 값은 100K에서 1M 사이이고, /autocompact auto로 모델 기본값으로 되돌릴 수 있습니다.
도구를 줄이는 쪽도 재 봤습니다. --restricted는 Bash·코드 실행·WebFetch 같은 도구를 빼는 모드인데, 결과는 16.5k에서 13.6k로 2.9k 감소였습니다. 다만 이 모드는 사용자·프로젝트·로컬 설정 파일을 무시해서 측정표에서 Memory files 줄 자체가 사라졌습니다. CLAUDE.md도 안 읽힌다는 뜻이라, 토큰 절약 목적으로 쓸 만한 옵션은 아닙니다.
--disable-slash-commands로 스킬 1.8k를 없애 보려 했더니 /context isn’t available in this environment.이 돌아왔습니다. /context 자체가 슬래시 명령이라 같이 꺼집니다. 측정 도구를 끄면 측정이 안 되는 건 당연한데, 실제로 부딪히기 전엔 생각 못 했습니다.
압축에서 살아남는 것과 사라지는 것
컨텍스트가 차면 Claude Code는 대화를 요약해 압축합니다. 이때 무엇이 남는지는 “어떻게 올라왔는가”에 따라 갈립니다. 공식 문서가 표로 정리해 둔 부분입니다.
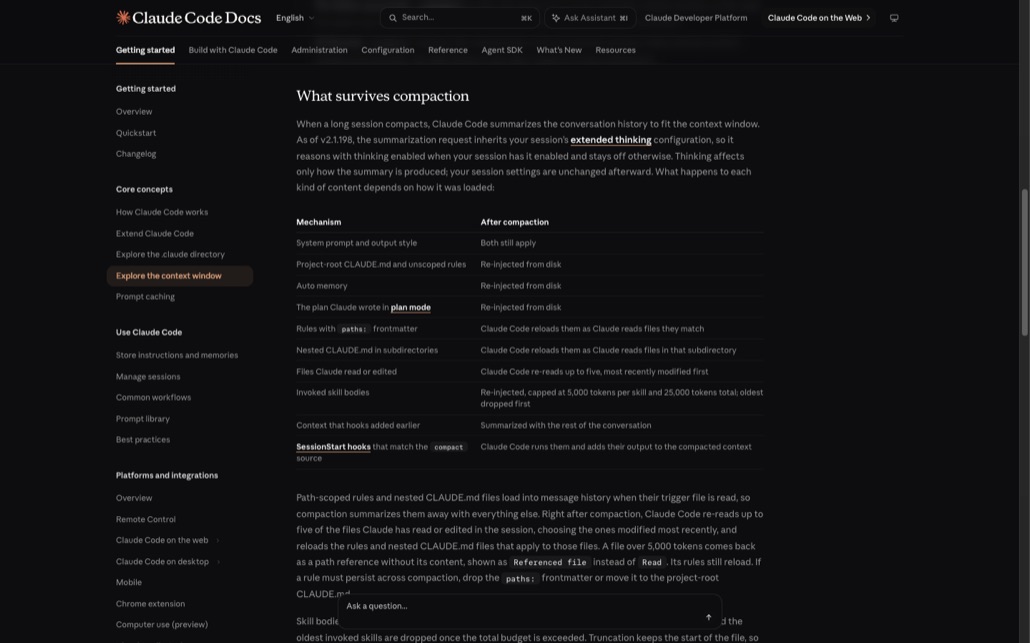
실무에서 걸리기 쉬운 지점만 추리면 이렇습니다.
| 이렇게 두면 | 압축 뒤 |
|---|---|
| 프로젝트 루트 CLAUDE.md, 범위 없는 규칙 | 디스크에서 다시 주입됩니다. 확실히 남습니다 |
| paths: 프론트매터가 붙은 규칙 | 해당 파일을 다시 읽을 때만 돌아옵니다. 반드시 유지돼야 하면 paths:를 떼거나 루트 CLAUDE.md로 옮기라고 문서가 안내합니다 |
| 읽거나 고친 파일 | 최근 수정순으로 최대 5개만 다시 읽습니다. 5,000토큰이 넘는 파일은 내용 없이 경로만 Referenced file로 돌아옵니다 |
| 호출된 스킬 본문 | 스킬당 5,000토큰, 총 25,000토큰 상한으로 재주입되고 오래된 것부터 버려집니다. 잘릴 때 앞부분이 남으므로 중요한 지시는 SKILL.md 위쪽에 두세요 |
| 스킬 설명 목록 | 시작할 때와 달리 압축 뒤에는 다시 실리지 않습니다. 실제로 호출했던 스킬만 남습니다 |
그래서 무엇부터 하면 되나
측정한 것들을 비용 대비 효과 순으로 놓으면 이렇습니다.
1. 먼저 재 보세요/context 한 번이면 내 환경의 고정비가 나옵니다. 짐작으로 줄이기 시작하면 엉뚱한 걸 건드립니다. 제 경우 개인 스킬·서브에이전트까지 얹힌 실제 작업 환경은 빈 환경보다 700토큰 정도 더 썼습니다.
2. CLAUDE.md를 200줄 아래로가장 확실한 고정비 절감입니다. 참고 자료성 내용은 스킬로 옮기면 쓸 때만 로드됩니다. 242줄에서 5.7k였으니, 절반으로 줄이면 대략 3k가 매 요청에서 빠집니다.
3. 작업이 바뀌면 /clear이전 작업의 파일 읽기 기록은 다음 작업에 도움이 안 되면서 매 메시지마다 비용을 발생시킵니다. 문서도 “관련 없는 작업으로 넘어갈 때”를 기준으로 제시합니다.
4. 큰 탐색은 서브에이전트로파일 내용이 서브에이전트 창에 남고 내 창에는 요약만 돌아옵니다. 구조적으로 가장 효과가 큰 방법이고, 이건 Claude Code가 “just in time” 전략을 쓰는 방식이기도 합니다.
5. 압축은 방향을 줘서/compact 뒤에 초점을 적으면(예: /compact 인증 버그 수정에 집중) 자동 압축이 알아서 고르는 대신 내가 남길 것을 정할 수 있습니다.
반대로 권하지 않는 것도 분명해졌습니다. 창을 좁히는 것(버퍼 비율이 급등), --restricted로 도구를 빼는 것(CLAUDE.md까지 무시됨), 스킬을 통째로 끄는 것(1.8k 아끼려다 /context를 포함한 슬래시 명령 전체가 사라짐). 셋 다 아끼는 양에 비해 잃는 게 큽니다.
자주 묻는 질문
컨텍스트 창이 100만이면 그냥 다 넣으면 되지 않나요?
공식 문서 기준으로도 아닙니다. Anthropic은 토큰 수가 늘수록 회상 정확도가 떨어지는 현상을 컨텍스트 로트로 부르고 “모든 모델에서 나타난다”고 적습니다. 창 크기는 담을 수 있는 한도이고, 잘 쓰는 능력은 별개입니다.
측정한 16.5k는 제 환경에서도 같나요?
다를 겁니다. 설치한 MCP 서버, 개인 스킬과 서브에이전트, 전역 CLAUDE.md가 모두 더해집니다. 이 글의 숫자는 개인 설정을 격리한 빈 프로젝트 기준이라 사실상 하한선에 가깝습니다. 본인 값은 /context로 직접 확인하세요.
deferred 항목은 결국 비용인가요 아닌가요?
지금은 아니고 나중에 될 수 있습니다. 이름만 올라가 있다가 작업에 필요해지면 스키마가 로드됩니다. MCP 서버를 많이 붙여 뒀다면 평소엔 안 보이다가 특정 작업에서 갑자기 컨텍스트가 뛰는 이유가 여기 있습니다.
Sonnet 5가 Opus 5보다 고정비가 크면 손해인가요?
그 항목만 보면 그렇지만 14k 차이는 1M 창에서 1.4%입니다. 모델 선택은 성능·속도·요금으로 정하는 게 맞고, 고정비 차이는 200k 창처럼 여유가 빠듯할 때만 실제로 체감됩니다.
이 측정에 한계는 없나요?
있습니다. /context가 내놓는 값은 문서 표기대로 “추정치(Estimated usage)”이고, 저는 세션을 시작한 직후 상태만 쟀습니다. 파일을 읽고 대화가 쌓인 뒤의 변화, 실제 압축이 일어나는 순간의 동작까지는 이번에 확인하지 않았습니다.
측정은 2026년 9월 15일 macOS에서 Claude Code v2.1.271로 실행했습니다. 임시 프로젝트에 CLAUDE_CONFIG_DIR을 지정해 개인 설정을 격리한 뒤 claude -p "/context"를 모델·옵션별로 반복 실행한 결과이며, /context가 표시하는 값은 공식 표기대로 추정치입니다. 정의와 압축 규칙은 Anthropic 엔지니어링 블로그(2025년 9월 29일 발행)와 Claude Code 공식 문서의 context window·model configuration·memory 페이지를 2026년 9월 15일 기준으로 대조했습니다.
Anthropic: Effective context engineering for AI agents ↗ · Explore the context window ↗ · Model configuration ↗ · How Claude remembers your project ↗