가격표부터 다시
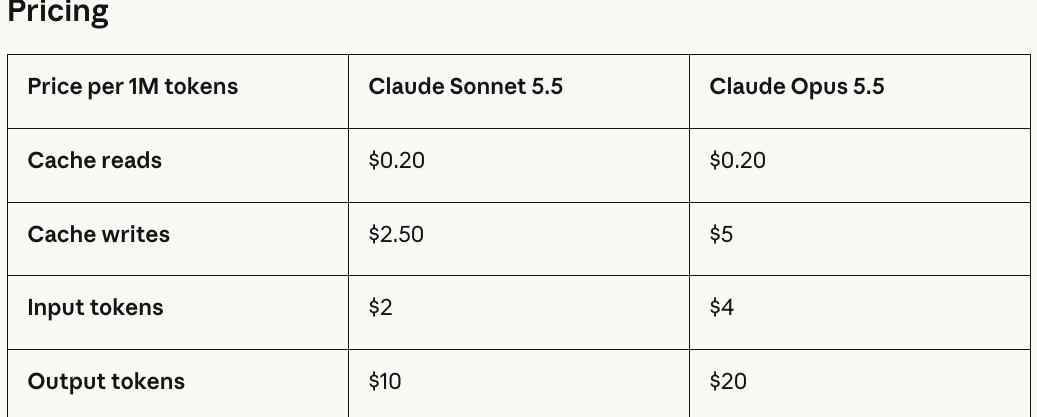
두 모델의 공식 단가는 이렇습니다. Anthropic의 Introducing Claude Sonnet 5.5·Introducing Claude Opus 5.5 발표문 기준입니다.
| 가격(백만 토큰당) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 입력 | $2 | $4 |
| 출력 | $10 | $20 |
| 캐시 쓰기 | $2.50 | $5 |
| 캐시 읽기 | $0.20 | $0.20 |
표에서 바로 보이는 사실이 하나 있습니다. 입력·출력·캐시 쓰기는 Opus가 정확히 2배지만, 캐시 읽기 단가는 두 모델이 완전히 같습니다. 이게 아래 계산에서 중요한 변수가 됩니다.
토큰 계산: 세 가지 작업
같은 토큰 수를 두 모델에 그대로 넣었을 때 비용이 얼마나 벌어지는지 세 가지 시나리오로 계산했습니다. 실제 작업은 이보다 복잡하지만, 청구서에 찍히는 토큰 단가 자체는 이 계산과 정확히 같은 방식으로 곱해집니다.
| 시나리오 | 토큰 구성 | Sonnet 5.5 | Opus 5.5 | 배율 |
|---|---|---|---|---|
| 짧은 질문 응답 | 입력 2,000 · 출력 500 | $0.009 | $0.018 | 2.0배 |
| 중간 코딩 작업(캐시 없음) | 입력 100,000 · 출력 20,000 | $0.40 | $0.80 | 2.0배 |
| 긴 리팩터링(캐시 없음) | 입력 500,000 · 출력 80,000 | $1.80 | $3.60 | 2.0배 |
캐시를 안 쓰면 배율은 항상 정확히 2배입니다. 가격표 자체가 2배 관계이기 때문입니다. 다만 Sonnet 5.5 발표문은 같은 작업에 “더 적은 토큰이 필요해 작업당 최대 30% 더 저렴하다”고 밝혔으므로, 토큰 단가의 2배 차이에 이 토큰 절약분까지 더해지면 실제 청구액 차이는 2배보다 커질 수 있습니다. 이 30% 수치는 Anthropic의 자체 테스트 기준이며, 테크로그가 두 모델에 같은 프롬프트를 직접 돌려 재현하지는 않았습니다.
캐시를 많이 쓰면 격차가 줄어듭니다
긴 시스템 프롬프트나 코드베이스 컨텍스트를 매 턴 재사용하는 에이전트 작업에서는 캐시 읽기 비중이 커집니다. 캐시 읽기 단가가 두 모델 모두 $0.20으로 같다는 점이 여기서 효과를 냅니다.
첫 턴: 캐시 쓰기 50,000 토큰
이후 19턴: 매 턴 캐시 읽기 50,000 + 새 입력 1,000 + 출력 500

Sonnet 5.5 = 캐시쓰기(0.05×$2.50) + 19×[캐시읽기(0.05×$0.20) + 입력(0.001×$2) + 출력(0.0005×$10)]
           = $0.125 + 19×($0.010+$0.002+$0.005) = $0.125 + $0.323 = 약 $0.45

Opus 5.5  = 캐시쓰기(0.05×$5) + 19×[캐시읽기(0.05×$0.20) + 입력(0.001×$4) + 출력(0.0005×$20)]
           = $0.25 + 19×($0.010+$0.004+$0.010) = $0.25 + $0.456 = 약 $0.71
이 예시에서 배율은 2.0배가 아니라 약 1.6배로 줄어듭니다. 캐시 읽기라는 “같은 단가” 구간이 전체 비용에서 차지하는 비중이 커질수록, Opus를 골라도 상대적인 추가 비용 부담이 줄어든다는 뜻입니다. 반대로 캐시를 전혀 안 쓰는 일회성 질문이 많다면 2배 차이가 그대로 유지됩니다. 프롬프트 캐싱 자체를 다룬 글과 배치 API로 50% 할인받는 법도 비용을 더 줄이는 방법입니다.
모델 바꾸는 법: 세 곳
같은 작업이라도 어디서 실행하느냐에 따라 기본 모델과 바꾸는 방법이 다릅니다.
| 환경 | 기본 모델 | 바꾸는 법 |
|---|---|---|
| Claude Code(CLI) | Opus 5.5 | /model 입력 후 목록에서 선택. modelPicker 설정으로 목록에 나올 모델을 제한할 수 있음 |
| claude.ai(채팅) | 플랜별 기본값(Pro는 Sonnet 계열) | 메시지창 상단 모델 선택 드롭다운 |
| API(Claude Platform) | 지정한 모델 ID 그대로 | 요청의 model 파라미터에 claude-sonnet-5-5 또는 claude-opus-5-5 지정 |
Claude Code에서 세션을 시작할 때마다 특정 모델로 고정하고 싶다면 환경변수 ANTHROPIC_DEFAULT_MODEL을 설정하면 됩니다. 이 값은 Claude Code 2026년 8월 週 다이제스트에 추가된 기능으로, 9월 업데이트 정리 글에서 다룬 자동 모드와는 별개 설정입니다.
노력(effort) 값도 비용에 영향
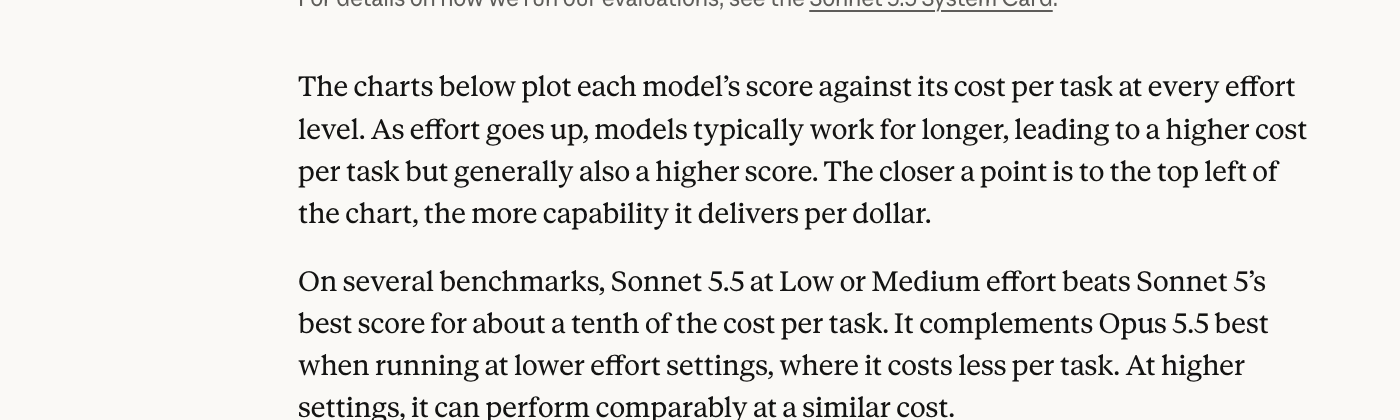
모델 선택과 별개로 각 모델은 Low·Medium·High·Xhigh·Max 다섯 단계의 노력(effort) 값을 지원합니다. Claude Code와 claude.ai 앱은 두 모델 모두 기본값이 Medium입니다. 단, API(Claude Platform)에서는 두 모델이 다릅니다. 공식 문서에 따르면 Sonnet 5.5는 API 기본값이 High이고(대부분의 다른 모델과 같은 규칙), Opus 5.5만 유일하게 API 기본값도 Medium입니다. 즉 Opus 5.5는 Claude Code·앱·API 세 곳 모두에서 Medium이 기본값이고, Sonnet 5.5는 API만 High가 기본값입니다. 노력을 높이면 모델이 더 오래 추론하면서 토큰을 더 많이 쓰고, 그만큼 작업당 비용도 올라갑니다. Anthropic의 Sonnet 5.5 발표문은 “Low나 Medium 노력에서 Sonnet 5.5가 Sonnet 5의 최고 점수를 10분의 1도 안 되는 비용으로 넘어선다”고 밝혔습니다. 즉 같은 모델이라도 노력 값을 낮추는 것이 다른 모델로 바꾸는 것보다 더 큰 비용 절감 효과를 낼 수 있습니다. 일상적인 반복 작업이라면 모델을 Opus에서 Sonnet으로 내리기 전에, 같은 모델에서 노력 값부터 낮춰보는 순서를 권합니다.
자주 묻는 질문
결국 어느 쪽이 더 쌀까요?
캐시를 거의 안 쓰는 작업은 Sonnet 5.5가 정확히 절반 가격입니다. 캐시 읽기 비중이 큰 장기 에이전트 세션일수록 두 모델의 실제 비용 차이는 좁혀집니다(위 예시 기준 약 1.6배).
Opus 5.5가 더 비싼데도 쓸 이유가 있나요?
비용 계산은 토큰 단가일 뿐, 결과물 품질이나 필요한 시도 횟수는 반영하지 않습니다. Opus 5.5로 한 번에 통과하는 작업을 Sonnet 5.5로 두세 번 다시 시도해야 한다면 총비용은 역전될 수 있습니다. 작업 난이도가 높을수록 이 재시도 비용까지 감안해야 합니다.
Batch API를 쓰면 이 계산이 어떻게 바뀌나요?
Batch API 글에서 다룬 것처럼 배치 처리는 입력·출력 단가에 50% 할인이 붙습니다. 위 표의 모든 금액에 0.5를 곱하면 배치 처리 시 예상 비용이 됩니다. 다만 배치는 실시간 응답이 아니므로 대화형 작업에는 맞지 않습니다.