바이브코딩은 제품명이 아니라 대화형 개발 방식입니다
검색 결과에는 AI 웹 빌더, AI 코드 에디터, 터미널 에이전트가 모두 ‘바이브코딩 툴’로 묶여 나옵니다. 공통점은 사용자가 구현 문법보다 원하는 동작을 먼저 말한다는 점입니다. 에이전트는 그 지시를 바탕으로 파일을 읽고 만들며, 명령을 실행하고 오류가 나면 다시 수정합니다. 사용자는 화면·테스트·변경 내역을 보고 다음 지시를 줍니다.
이 방식은 노코드와도 다릅니다. 노코드는 미리 정해진 블록과 설정 범위 안에서 조립하지만, 바이브코딩 도구는 실제 HTML, JavaScript, Python 같은 코드를 생성합니다. 그래서 자유도가 큰 대신 생성된 코드의 보안, 데이터 처리, 배포 비용까지 사용자 책임으로 돌아옵니다. “코드를 몰라도 시작할 수 있다”와 “코드를 몰라도 검토할 필요가 없다”는 전혀 다른 주장입니다.
언어·프레임워크보다 입력 → 규칙 → 출력 → 실패 조건 네 칸을 먼저 적습니다. AI가 화면 스타일을 추측하게 둘 수는 있어도 계산 규칙과 실패 조건까지 추측하게 두면, 겉보기에는 그럴듯하고 결과는 틀린 앱이 나옵니다.
직접 실험: 회식비 정산기는 어디까지 한 번에 만들어졌나
글을 쓰면서 빈 폴더에서 작은 정산기를 만들었습니다. 요구사항은 “결제 총액과 인원을 입력받고, 1인 금액을 100원 단위로 올림하며, 총 수금액과 남는 금액을 보여준다”였습니다. 프레임워크와 서버는 쓰지 않고 브라우저에서 바로 실행되는 HTML·JavaScript로 제한했습니다. 결과 화면을 만든 뒤 계산 함수를 별도 파일로 분리하고 네 가지 테스트를 실행했습니다.
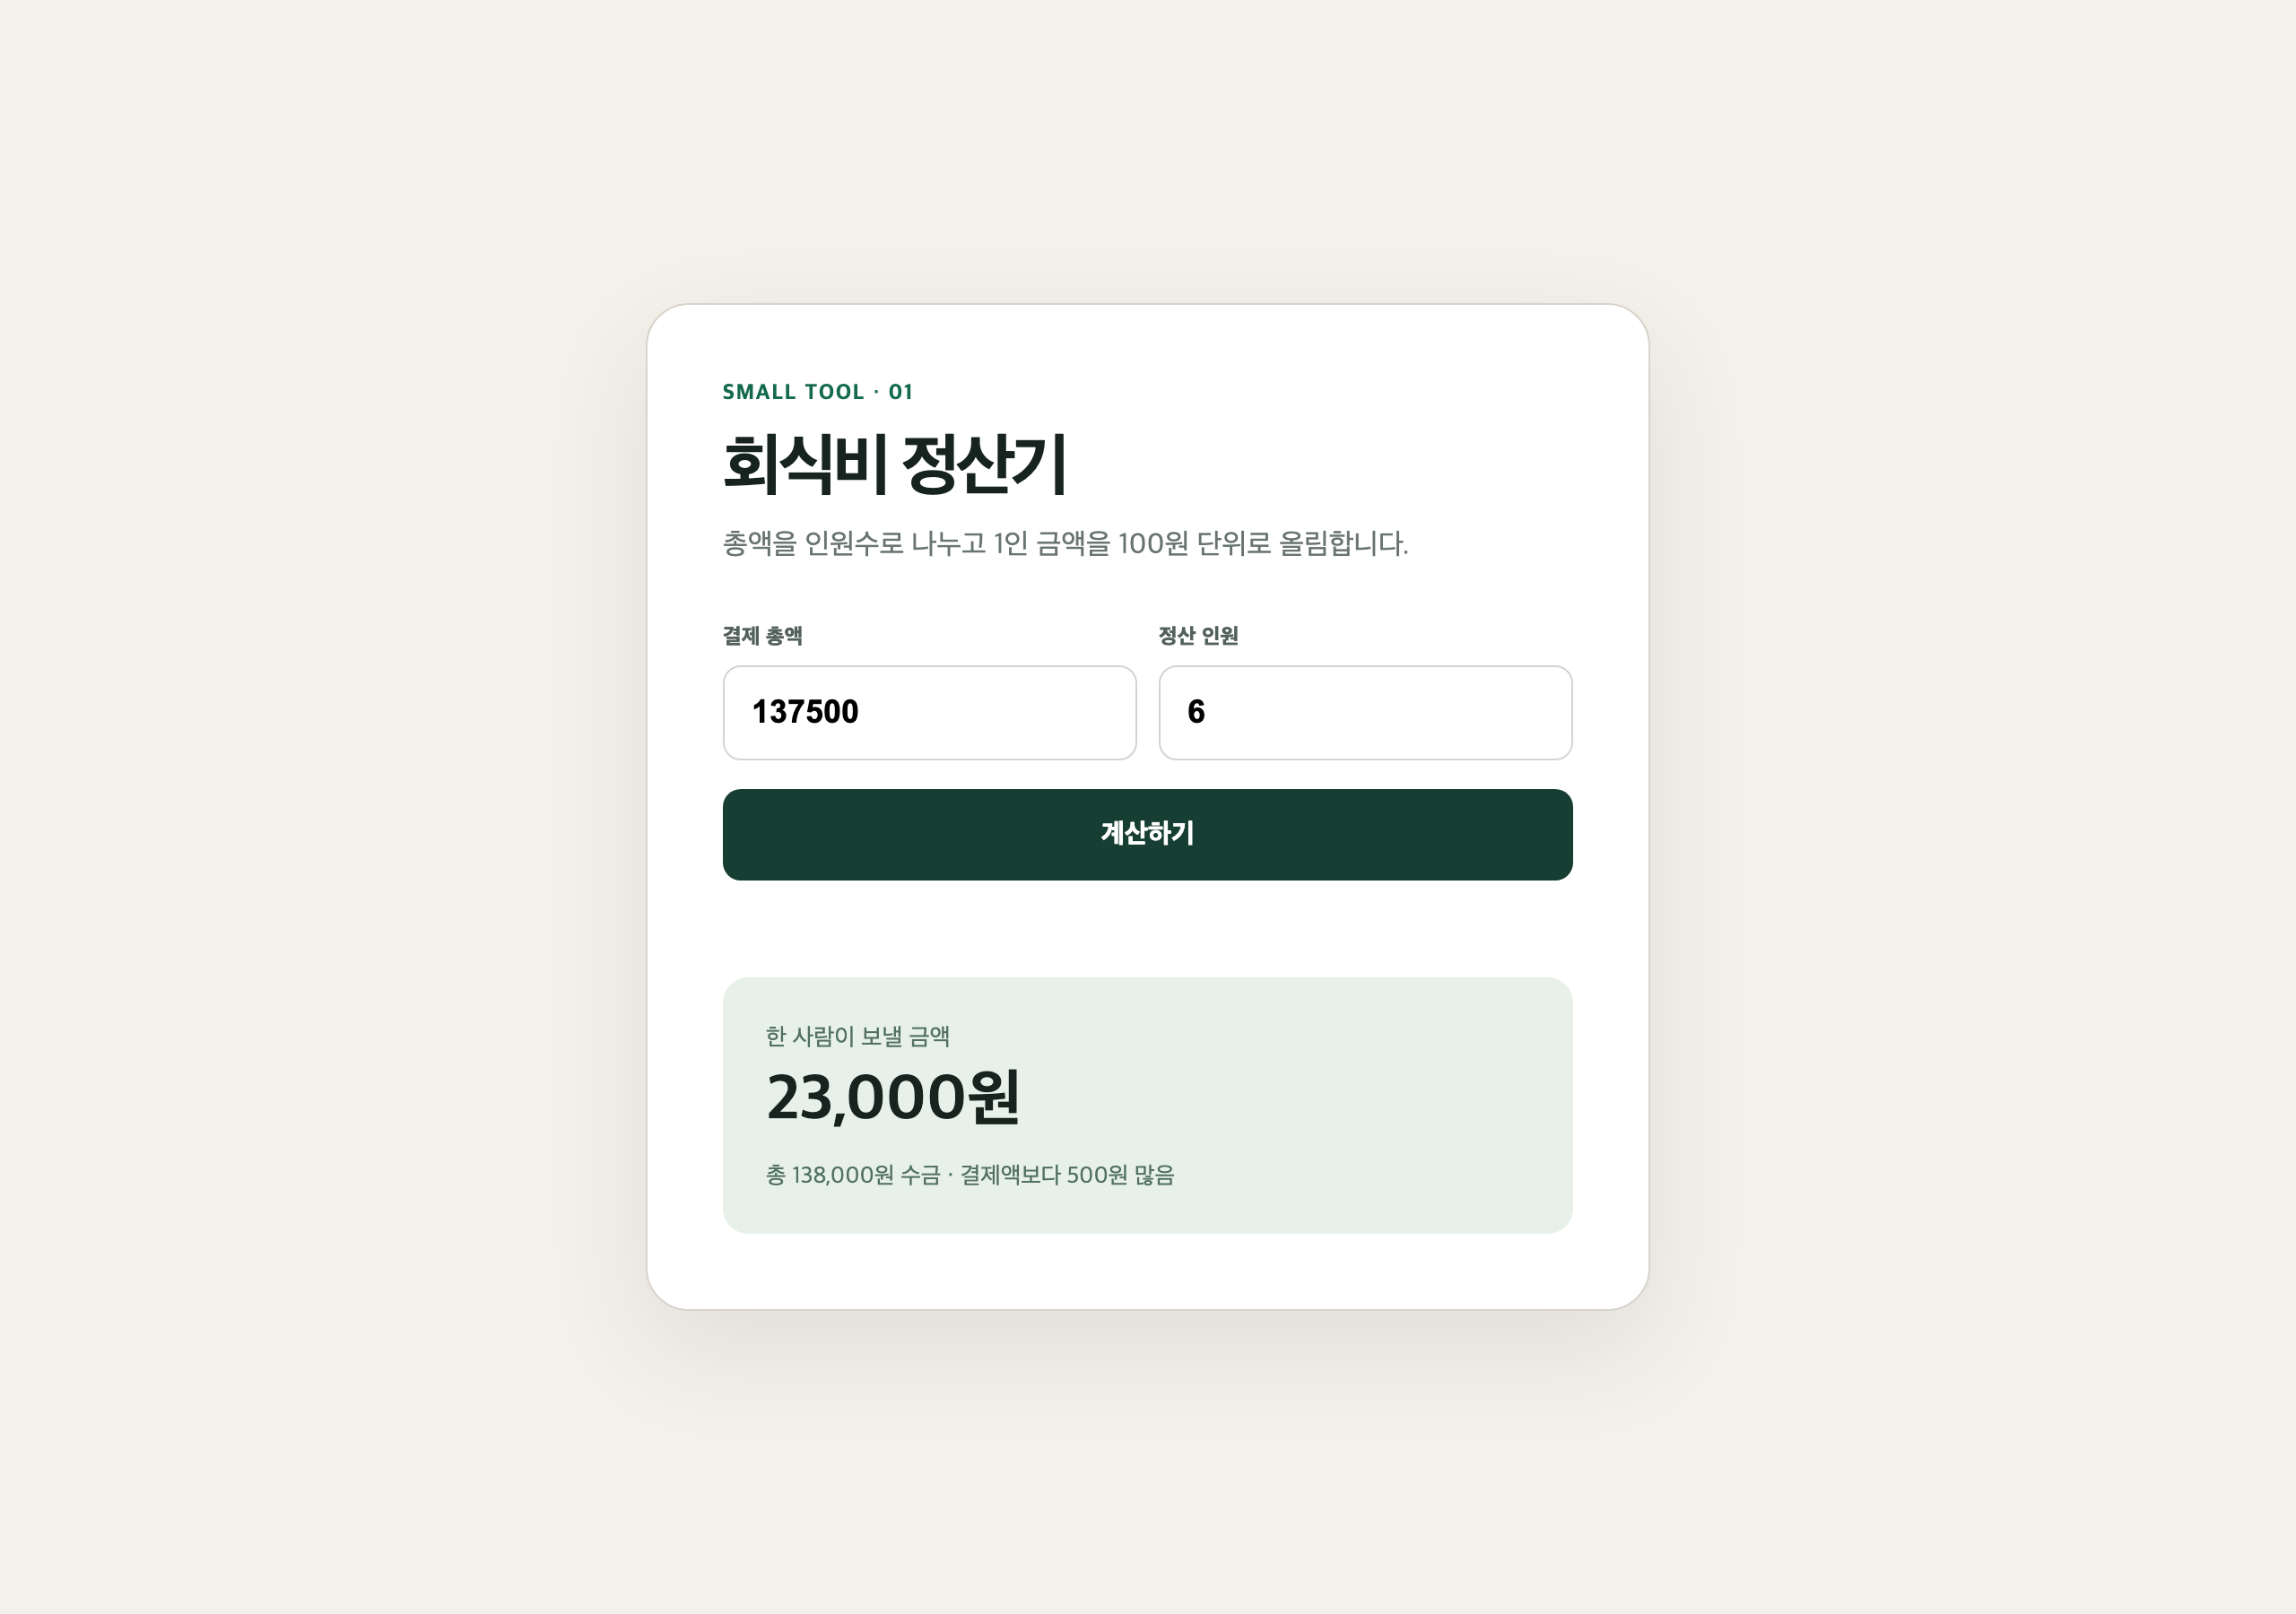
화면이 나온 것만으로 끝내지 않았습니다. 같은 나눗셈이 딱 나누어떨어지는 10,000원·4명, 인원이 1명인 잘못된 입력, 총액이 음수인 입력을 추가해 Node.js의 기본 assert로 검사했습니다. 실행 결과는 4개 테스트 통과: 나눗셈·100원 올림·인원 검증·금액 검증이었습니다. 이 작은 실험에서도 첫 화면보다 예외 처리와 검증을 붙이는 데 더 구체적인 지시가 필요했습니다.
export function splitBill(total, people) {
  const amount = Number(total);
  const count = Number(people);
  if (!Number.isFinite(amount) || amount <= 0)
    throw new Error('총액은 0보다 커야 합니다.');
  if (!Number.isInteger(count) || count < 2)
    throw new Error('인원은 2명 이상 정수로 입력하세요.');
  const each = Math.ceil(amount / count / 100) * 100;
  return { each, collected: each * count,
    remainder: each * count - amount };
}
이 코드에서 가장 중요한 줄은 색상이나 버튼이 아니라 올림 규칙입니다. ‘적당히 나눠줘’라고만 했다면 1원 단위 반올림, 마지막 한 명에게 잔액 몰기, 모두 같은 금액 보내기 중 무엇을 원하는지 에이전트가 임의로 골랐을 수 있습니다. 바이브코딩에서 좋은 요구사항은 긴 기술 문서가 아니라, 결과가 갈리는 지점을 숫자와 예시로 못 박는 문장입니다.
첫 프롬프트에는 기능보다 완료 조건을 씁니다
“예쁜 정산 앱 만들어줘”도 화면은 만듭니다. 하지만 완료 여부를 판정할 수 없습니다. 아래처럼 결과물 위치, 입력, 계산 규칙, 오류 조건, 검증 명령을 한 묶음으로 주면 에이전트가 스스로 확인할 여지가 생깁니다.
빈 폴더에 브라우저용 회식비 정산기를 만들어줘.

- 입력: 결제 총액, 정산 인원
- 규칙: 1인 금액은 100원 단위로 올림
- 출력: 1인 금액, 총 수금액, 결제액보다 남는 금액
- 오류: 총액은 양수, 인원은 2명 이상 정수
- 제약: 프레임워크와 외부 패키지 없이 HTML/CSS/JS 사용
- 검증: 계산 함수를 분리하고 정상 2건·오류 2건 테스트
- 완료 보고: 만든 파일, 테스트 명령과 결과를 요약
처음부터 디자인 세부값을 스무 개 적을 필요는 없습니다. 1차 요청은 동작과 실패 조건에 집중하고, 브라우저에서 결과를 본 뒤 “모바일에서 입력을 한 줄씩 배치”, “계산 결과 대비를 높이기”, “Enter 키로도 실행”처럼 눈으로 판정할 수 있는 수정 요청을 보냅니다. 한 번의 거대한 프롬프트보다 작은 완료 단위를 연속해서 닫는 쪽이 오류 위치를 찾기 쉽습니다.
좀 더 프로답게 해줘.
520px 이하에서는 입력 두 개를 세로로 배치하고, 결과 금액을 본문보다 두 배 이상 크게 보여줘.
도구는 실력보다 작업 위치에 맞춰 고릅니다
모델 순위만 보고 고르면 실제 작업과 맞지 않을 수 있습니다. 같은 AI 코딩이라도 브라우저 빌더는 배포된 화면에 빨리 도달하는 데 강하고, AI 에디터는 코드를 직접 읽으면서 고치기 좋으며, 터미널·데스크톱 에이전트는 저장소 전체와 테스트·빌드까지 맡기기 좋습니다. 첫 도구는 앞으로 어디에서 검토할지를 기준으로 정합니다.
| 작업 상황 | 맞는 유형 | 대표 선택지 | 먼저 확인할 점 |
|---|---|---|---|
| 설치 없이 아이디어 화면을 빨리 보고 싶다 | 브라우저 기반 앱 빌더 | 웹 빌더 계열 | 코드 내보내기, 데이터 저장 위치, 배포 잠금 |
| VS Code와 비슷한 화면에서 파일을 보며 수정한다 | AI 코드 에디터 | Cursor | diff 검토, 자동 실행 범위, 모델·사용량 정책 |
| 기존 저장소에서 여러 파일·테스트·빌드를 맡긴다 | 코딩 에이전트 | Codex 앱·CLI, Claude Code | 작업 폴더, 샌드박스·권한, Git 복구 지점 |
| 직접 코드를 거의 읽지 못한다 | 미리보기와 되돌리기가 쉬운 도구 | 체크포인트·버전 관리 지원 제품 | 오류 재현 방법과 외부 검토 경로 |
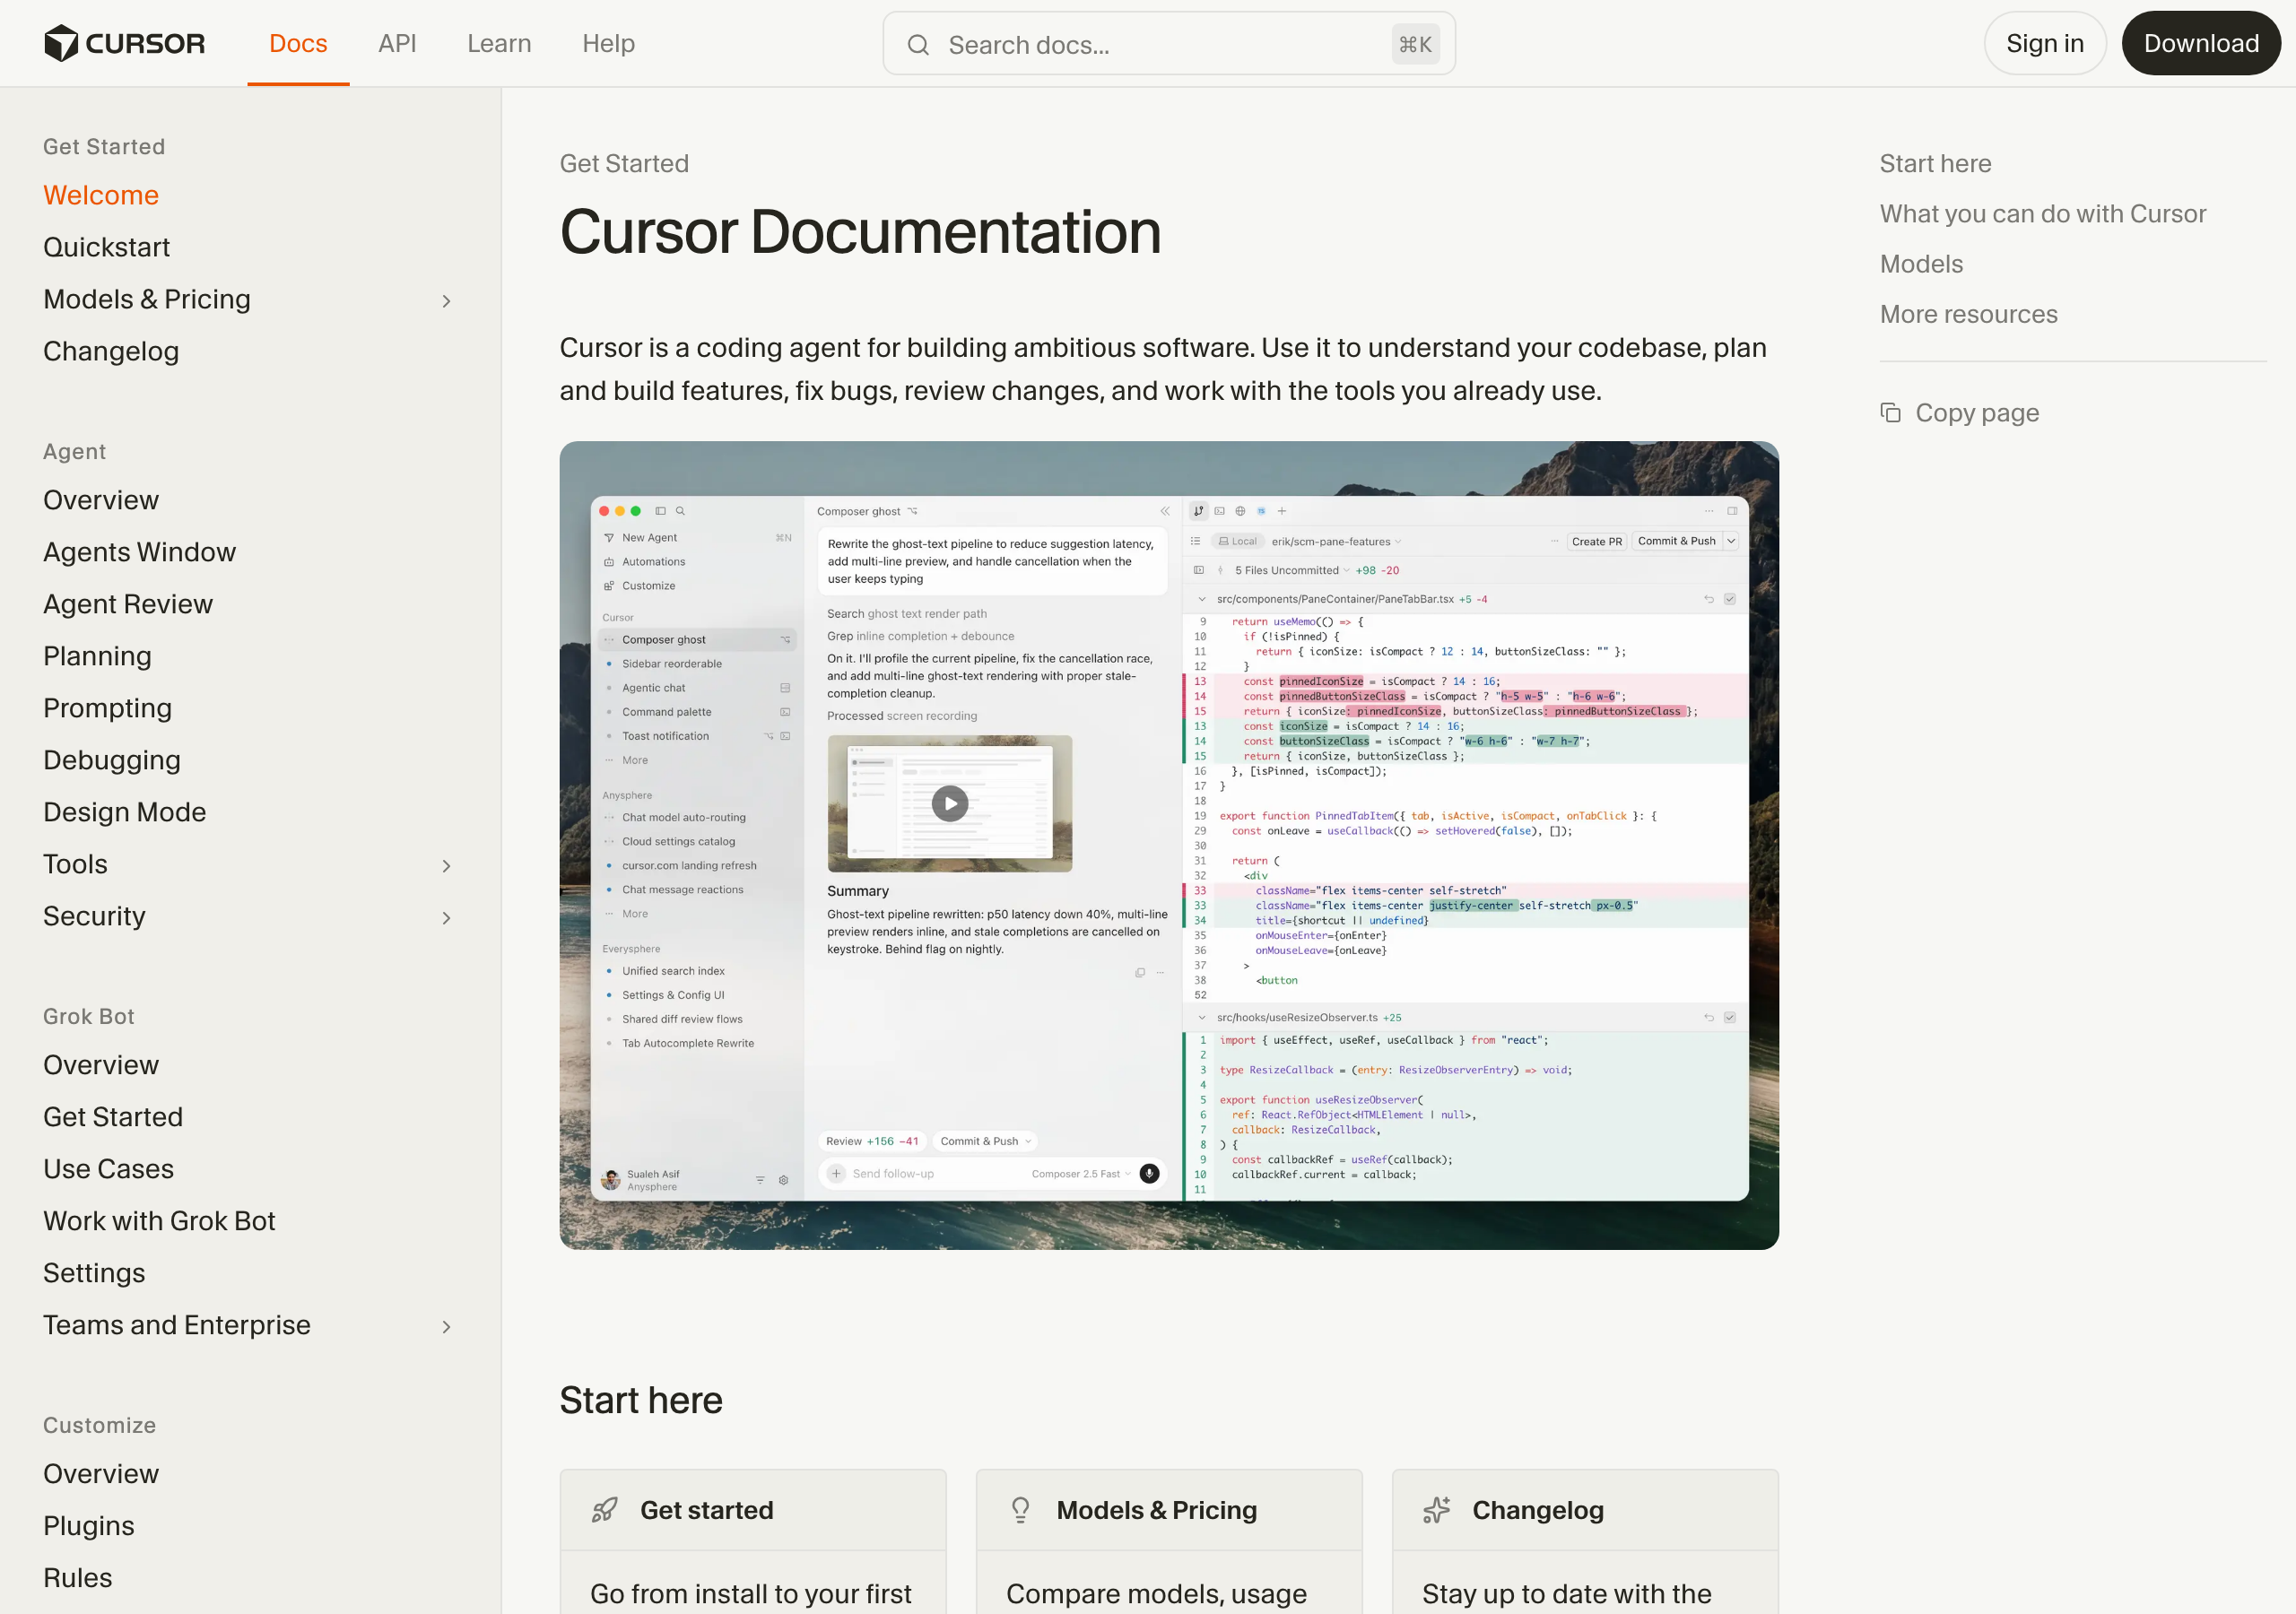
Cursor는 편집기 안에서 파일과 diff를 계속 보고 싶은 사람에게 자연스럽습니다. Claude Code는 터미널 중심 흐름에 익숙하고 셸 명령과 텍스트 출력을 선호할 때 맞습니다. Codex 앱은 여러 작업을 프로젝트 단위로 나누고 변경·터미널·미리보기를 함께 관리하려는 경우에 유리합니다. 셋 중 무엇이 ‘바이브코딩 전용’인 것은 아닙니다. 같은 작업을 어디서 지시하고 어디서 검토할지가 다릅니다.
유료 결제 전에는 한 도구에서 작은 과제를 끝까지 해보는 것이 낫습니다. 빈 프로젝트 생성, 수정 두 번, 잘못된 입력 테스트, Git diff 확인, 로컬 빌드까지 한 사이클을 완료해 보면 모델 답변 품질보다 자주 마주치는 승인창·사용량 제한·미리보기 동선이 드러납니다. 이 마찰이 실제 선택을 가릅니다.
프롬프트 → 실행 → 관찰 → 검증을 한 바퀴로 묶습니다
바이브코딩이 위험해지는 순간은 생성 속도가 검토 속도를 앞설 때입니다. 파일을 열 개 만든 뒤 한꺼번에 확인하면 어느 요청에서 문제가 들어왔는지 찾기 어렵습니다. 기능 하나가 끝날 때마다 아래 네 단계를 반복합니다.
- 프롬프트: 입력·출력·실패 조건과 건드리지 않을 범위를 적습니다.
- 실행: 에이전트가 만든 명령과 권한 요청을 읽고 허용 범위를 결정합니다.
- 관찰: 정상 화면만 보지 말고 빈 값, 매우 큰 값, 모바일 폭 같은 경계를 직접 넣습니다.
- 검증: 자동 테스트와 빌드를 실행하고 diff에서 예상하지 않은 파일 변경을 찾습니다.
테스트가 없는 작은 HTML이라도 검증 질문은 만들 수 있습니다. “인원이 1명이면?”, “총액에 문자가 들어가면?”, “나누어떨어지면 잔액은 0원인가?”, “새로고침 뒤 개인 정보가 남는가?”를 적고 하나씩 눌러 봅니다. 다음 요청은 “오류를 고쳐줘”가 아니라 “인원 1을 입력하면 현재 계산되는 문제를 재현하고, 2 이상 정수만 허용한 뒤 같은 입력이 막히는지 확인해줘”처럼 재현값을 포함합니다.
완료 보고는 주장입니다. 테스트 명령의 종료 코드, 브라우저에 표시된 결과, 변경된 파일 목록이 증거입니다. 세 가지 중 하나도 확인할 수 없다면 다음 기능으로 넘어가기 전에 검증 방법부터 추가합니다.
로그인·결제·개인정보 기능은 첫 프로젝트에서 빼는 게 좋습니다
정산기처럼 브라우저 안에서 계산만 하는 앱은 실패해도 영향이 작습니다. 반면 로그인, 결제, 파일 업로드, 고객 데이터베이스, 이메일 자동 발송은 잘못된 코드가 실제 사람과 데이터에 영향을 줍니다. API 키를 코드에 넣거나 공개 저장소에 올리는 실수도 초보 프로젝트에서 자주 생깁니다.
처음 두세 개 프로젝트는 서버와 계정 없이 끝나는 도구가 알맞습니다. 타이머, 단위 변환기, 체크리스트, 로컬 CSV 요약처럼 입력을 사용자의 브라우저 안에서만 처리하는 주제를 고릅니다. 외부 API가 필요해지는 순간에는 키를 어디에 저장하는지, 요청 비용 상한이 있는지, 사용자 입력을 서버 로그에 남기는지 별도 검토 항목으로 분리합니다.
또 에이전트에게 넓은 권한을 주기 전에 Git 저장소를 만들고 첫 커밋을 남깁니다. Cursor 공식 보안 문서도 에이전트 변경이 작업공간 파일에 바로 저장될 수 있으므로 버전 관리를 사용해 되돌릴 수 있게 하라고 안내합니다. Codex는 기본적으로 작업 폴더·브랜치 안의 파일 편집과 제한된 검색만 허용하고, 네트워크처럼 높은 권한이 필요한 명령은 승인을 요청합니다. 제품별 표현은 달라도 초보자의 실천은 같습니다. 범위를 작게 열고, 변경을 확인한 뒤 넓힙니다.
첫 주에 만들기 좋은 순서
입력 두 개와 계산 규칙 하나로 시작합니다. 정상값 두 개, 오류값 두 개를 직접 정합니다.
추가·완료·삭제를 만들고 새로고침하면 초기화된다는 제약을 화면에 표시합니다.
모바일 배치나 키보드 조작처럼 눈으로 전후를 비교할 수 있는 변경을 요청하고 diff를 읽습니다.
빌드, 깨진 링크, 콘솔 오류, 비밀키 포함 여부를 검사합니다. 그다음에만 공개 URL을 만듭니다.
바이브코딩을 빨리 배우는 방법은 더 많은 도구를 설치하는 것이 아니라 작은 결과물을 완성 상태로 닫는 것입니다. 첫 화면을 만드는 데 10분이 걸리고 검증에 30분이 걸려도 정상입니다. 그 30분 동안 요구사항을 판정 가능한 문장으로 바꾸는 법을 배우며, 그 능력은 도구나 모델이 바뀌어도 그대로 남습니다.
OpenAI Codex 앱 소개와 보안 안내, Cursor 공식 문서의 Agent·diff review·security, Anthropic Claude Code 설치 문서를 2026년 9월 2일 확인했습니다. 직접 실험은 외부 패키지 없는 HTML/CSS/JavaScript 앱으로 수행했고 Node.js 테스트 4건을 통과한 뒤 로컬 브라우저에서 화면과 계산값을 확인했습니다.
OpenAI · Introducing the Codex app ↗ · Cursor Docs ↗ · Cursor · Agent Security ↗ · Anthropic · Claude Code 시작하기 ↗